딥러닝 경사하강법의 갱신식 θ ← θ + 2αx(y − ŷ)를 미분 한 번으로 직접 유도하고, 수치 미분과 C++·파이썬 실행 결과로 맞는지 확인합니다.
1편에서는 θ를 고치는 식 θ ← θ + 2αx(y − ŷ)를 일단 받아들이고 학습 결과부터 봤습니다. θ는 0.1에서 출발해 2.97 근처까지 잘 찾아갔습니다. 이번 글에서는 딥러닝 경사하강법의 이 한 줄이 어디서 나오는지 직접 유도하고, 유도한 식이 정말 맞는지 코드로 확인합니다.
연재 안내: 전체 12편의 순서와 공개된 글은 딥러닝 수학 C++ 구현 로드맵에서 확인할 수 있습니다.
한 줄 답변
갱신식은 “loss를 θ로 미분한 값(기울기)의 반대 방향으로 학습률만큼 움직인다”는 경사하강법의 규칙 θ ← θ − α · dL/dθ에, 미분 결과 dL/dθ = −2x(y − ŷ)를 대입한 것입니다. 마이너스 두 개가 만나 플러스가 되면서 θ ← θ + 2αx(y − ŷ)가 됩니다.
이 글에서 바로 답하는 것
- 기울기의 부호가 왜 θ를 움직일 방향을 알려 주는지
dL/dθ = −2x(y − ŷ)를 두 가지 방법으로 유도하는 과정- 유도한 식이 맞는지 수치 미분으로 확인하는 방법
- 같은 학습률인데 입력 x가 크면 왜 더 빨리 학습되는지
이 글에 나오는 용어
1편의 용어표에 더해 이번 글에서 새로 쓰는 용어입니다.
| 용어 | 뜻 |
|---|---|
| 미분 (derivative) | 입력을 아주 조금 바꿀 때 출력이 얼마나 바뀌는지의 비율. 그래프에서는 접선의 기울기 |
dL/dθ | “L을 θ로 미분한 값”이라고 읽음. θ를 조금 키울 때 loss가 얼마나 변하는지 |
| 연쇄법칙 (chain rule) | 함수 안에 함수가 들어 있을 때, 바깥 미분과 안쪽 미분을 곱해 전체 미분을 구하는 규칙 |
| 수치 미분 (numerical differentiation) | 공식 없이 θ를 아주 조금 늘리고 줄여서 loss 변화량으로 기울기를 어림하는 방법 |
| 오차 (error) | 정답에서 예측을 뺀 값 y − ŷ. 제곱하기 전의 차이 |
1단계: 기울기의 부호가 방향을 알려 줍니다
샘플 하나 (x, y) = (1, 3)을 고정하면 loss는 L(θ) = (3 − θ)²이라는 포물선입니다. 이 포물선 위의 두 점에서 접선을 그어 보겠습니다.
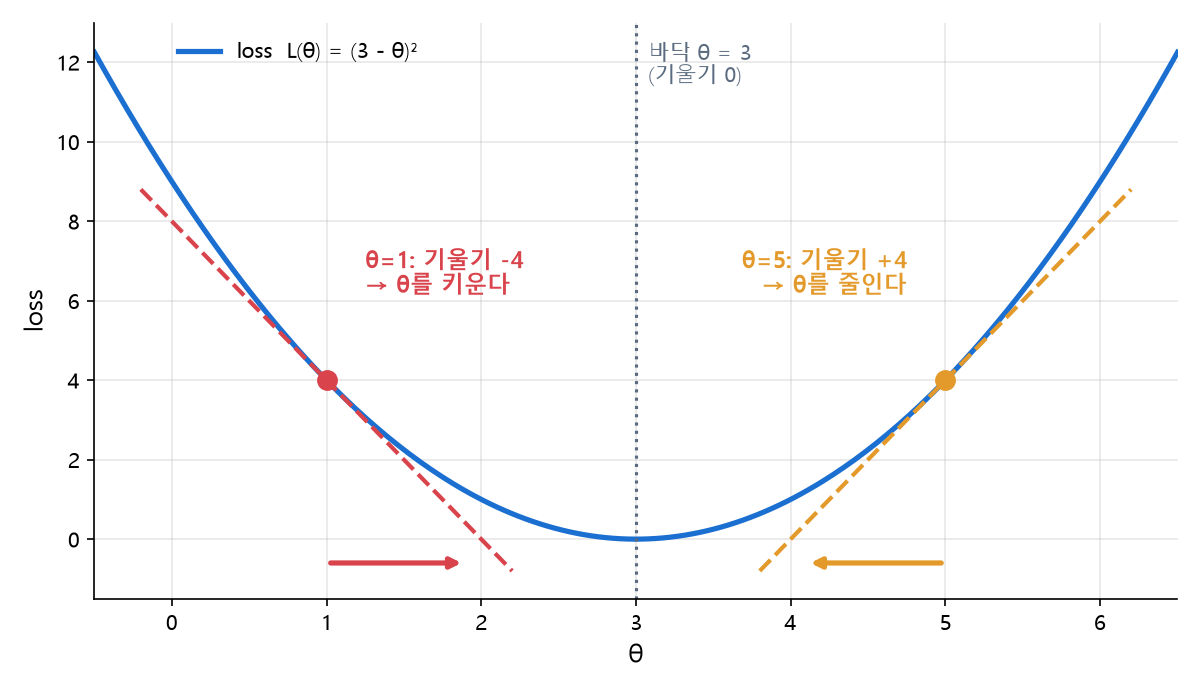
- θ = 1에서 접선 기울기는 −4입니다. 오른쪽으로 갈수록 loss가 내려간다는 뜻이므로 θ를 키워야 합니다.
- θ = 5에서 접선 기울기는 +4입니다. 오른쪽으로 갈수록 loss가 올라간다는 뜻이므로 θ를 줄여야 합니다.
- θ = 3(바닥)에서는 기울기가 0이므로 더 움직일 이유가 없습니다.
두 경우 모두 기울기와 반대 부호 쪽으로 움직이면 바닥에 가까워집니다. 그래서 경사하강법의 규칙은 다음과 같습니다.
θ ← θ − α · dL/dθ마이너스가 “반대 방향”을, 학습률 α가 “얼마나 크게”를 뜻합니다. 남은 일은 dL/dθ를 구하는 것뿐입니다.
2단계: 미분으로 기울기 식 구하기
loss는 L = (y − θx)²입니다. 두 가지 방법으로 미분해 보겠습니다. 결과는 같습니다.
방법 A. 전개해서 미분하기 (연쇄법칙 없이)
제곱을 먼저 풀면 θ에 대한 평범한 이차식이 됩니다.
L = y² − 2xyθ + x²θ²θ로 미분하면 θ가 없는 y²는 0이 되고, −2xyθ는 −2xy, x²θ²는 2x²θ가 됩니다.
dL/dθ = −2xy + 2x²θ
      = −2x(y − θx)
      = −2x(y − ŷ)
방법 B. 연쇄법칙으로 미분하기
오차를 e = y − θx로 두면 L = e²입니다. 바깥 함수(제곱)와 안쪽 함수(오차)를 따로 미분해서 곱합니다.
dL/de = 2e          ← 제곱의 미분
de/dθ = −x          ← y는 상수, −θx를 θ로 미분하면 −x
dL/dθ = dL/de × de/dθ = 2e × (−x) = −2x(y − ŷ)
방법 A가 이 경우에는 더 쉽지만, 모델이 복잡해지면 식을 일일이 전개하기가 현실적으로 어려워집니다. 그때 쓰는 것이 방법 B이고, 이 방식을 계산 그래프 전체로 넓힌 것이 4편에서 다룰 역전파입니다.
3단계: 규칙에 대입하면 갱신식이 나옵니다
1단계의 규칙에 2단계의 기울기를 넣습니다.
θ ← θ − α · (−2x(y − ŷ))
  = θ + 2αx(y − ŷ)
1편에서 그대로 받아들였던 식이 이렇게 나옵니다. 이 식은 세 부분으로 읽을 수 있습니다.
| 부분 | 의미 |
|---|---|
y − ŷ (오차) | 예측이 정답보다 작으면 양수 → θ를 키움. 크면 음수 → θ를 줄임. 맞으면 0 → 멈춤 |
x (입력) | 입력이 클수록 θ를 조금만 바꿔도 예측이 크게 변하므로, 그만큼 크게 고침 |
2α | 한 번에 움직이는 크기. 2는 제곱을 미분해서 생긴 상수 |
C++와 파이썬 코드로 확인하기
유도한 기울기 식이 맞는지 수치 미분으로 확인해 보겠습니다. θ를 아주 조금(h = 0.00001) 늘렸을 때와 줄였을 때 loss 차이를 2h로 나누면, 공식을 몰라도 그 점의 기울기를 어림할 수 있습니다. 두 값이 같으면 유도가 맞은 것입니다.
C++ (C++17, 외부 라이브러리 없음)
#include <cstdio>
#include <initializer_list>

double Loss(double th, double x, double y) { return (y - th * x) * (y - th * x); }

double Grad(double th, double x, double y) { return -2.0 * x * (y - th * x); }   // 손으로 유도한 기울기

double NumericGrad(double th, double x, double y, double h = 1e-5) {            // 수치 미분으로 확인
    return (Loss(th + h, x, y) - Loss(th - h, x, y)) / (2.0 * h);
}

double TrainSingleSample(int iterations, double lr, double x, double y, double th = 0.1) {
    for (int it = 0; it < iterations; ++it) {
        const double pred = th * x;                       // 1) 예측
        th = th - lr * (-2.0 * x * (y - pred));           // 2) θ ← θ − α · dL/dθ
    }
    return th;
}

int main() {
    std::printf("x=1, th=1: grad %.6f, numeric %.6fn", Grad(1, 1, 3), NumericGrad(1, 1, 3));
    std::printf("x=2, th=1: grad %.6f, numeric %.6fn", Grad(1, 2, 6), NumericGrad(1, 2, 6));
    std::printf("x=1, th=5: grad %.6f, numeric %.6fn", Grad(5, 1, 3), NumericGrad(5, 1, 3));
    for (double x : {0.5, 1.0, 2.0})
        std::printf("x=%.1f: th after 20 updates = %.5fn", x, TrainSingleSample(20, 0.1, x, 3 * x));
}
Python (표준 라이브러리만 사용)
def loss(th, x, y):
    return (y - th * x) ** 2

def grad(th, x, y):                          # 손으로 유도한 기울기
    return -2 * x * (y - th * x)

def numeric_grad(th, x, y, h=1e-5):          # 수치 미분으로 확인
    return (loss(th + h, x, y) - loss(th - h, x, y)) / (2 * h)

def train_single_sample(iterations, lr, x, y, th=0.1):
    for _ in range(iterations):
        pred = th * x                         # 1) 예측
        th = th - lr * (-2 * x * (y - pred))  # 2) θ ← θ − α · dL/dθ
    return th

print(f"x=1, th=1: grad {grad(1, 1, 3):.6f}, numeric {numeric_grad(1, 1, 3):.6f}")
print(f"x=2, th=1: grad {grad(1, 2, 6):.6f}, numeric {numeric_grad(1, 2, 6):.6f}")
print(f"x=1, th=5: grad {grad(5, 1, 3):.6f}, numeric {numeric_grad(5, 1, 3):.6f}")
for x in [0.5, 1.0, 2.0]:
    print(f"x={x:.1f}: th after 20 updates = {train_single_sample(20, 0.1, x, 3 * x):.5f}")
이번 코드는 난수를 쓰지 않으므로 두 언어의 출력이 똑같습니다.
실행 결과
x=1, th=1: grad -4.000000, numeric -4.000000
x=2, th=1: grad -16.000000, numeric -16.000000
x=1, th=5: grad 4.000000, numeric 4.000000
x=0.5: th after 20 updates = 1.96039
x=1.0: th after 20 updates = 2.96657
x=2.0: th after 20 updates = 3.00000
세 지점 모두 유도한 기울기와 수치 미분 값이 소수점 여섯째 자리까지 같습니다. 그림에서 본 −4와 +4도 그대로 나왔습니다. 갱신식의 출발점인 기울기 식이 맞다는 확인입니다.
수치 미분을 처음부터 쓰면 안 될까? 파라미터가 하나일 때는 괜찮지만, 파라미터가 백만 개면 loss를 백만 번 이상 다시 계산해야 해서 너무 느립니다. 그래서 학습에는 유도한 식(또는 역전파)을 쓰고, 수치 미분은 “내 미분이 맞는지” 확인하는 용도로만 씁니다.
같은 학습률인데 x가 크면 더 빨리 배웁니다
출력의 아래 세 줄은 정답이 모두 3인 샘플 세 개(x = 0.5, 1, 2)를 같은 학습률 0.1로 각각 20번 갱신한 결과입니다. 결과 차이가 꽤 큽니다.
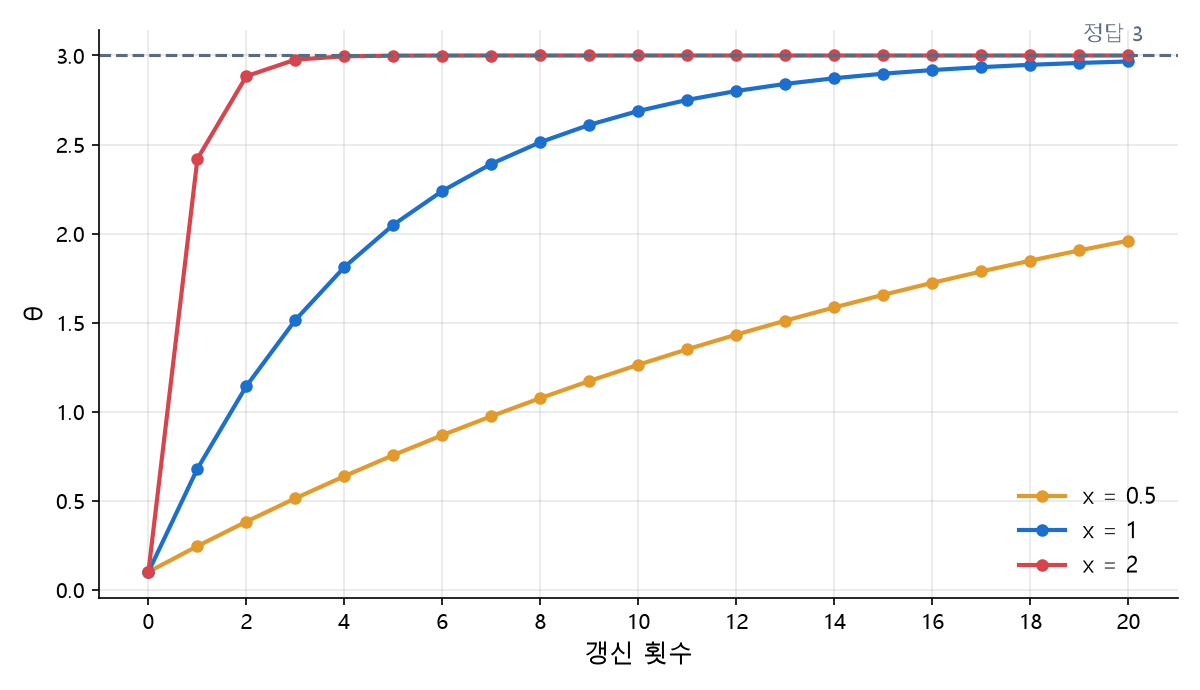
| 입력 x | 첫 갱신 후 θ | 20번 갱신 후 θ | 남은 거리가 매번 줄어드는 배수 |
|---|---|---|---|
| 0.5 | 0.245 | 1.96039 | 0.95 |
| 1 | 0.68 | 2.96657 | 0.8 |
| 2 | 2.42 | 3.00000 | 0.2 |
갱신식 θ ← θ + 2αx(y − ŷ)에서 y − ŷ = x(3 − θ)이므로, 정리하면 한 번 갱신할 때마다 정답까지 남은 거리 3 − θ가 (1 − 2x²α)배가 됩니다. x가 두 배가 되면 x²은 네 배가 되므로, x = 2일 때는 남은 거리가 한 번에 0.2배로 줄어 네 번 만에 거의 3에 닿습니다. x = 0.5일 때는 0.95배씩만 줄어서 20번이 지나도 절반을 조금 넘게 왔을 뿐입니다.
이 결과는 학습률을 정할 때 입력 x의 크기를 함께 봐야 한다는 뜻입니다. x가 크면 같은 학습률도 실제로는 큰 걸음이 되고, 그 걸음이 너무 커지면 바닥을 지나쳐 버립니다. (1 − 2x²α)가 음수가 되거나 −1보다 작아지면 어떤 일이 생기는지가 다음 편의 주제입니다.
흔히 헷갈리는 부분
기울기 앞의 마이너스를 빼먹기 쉽습니다
규칙은 θ − α·기울기이고, 기울기 자체에도 마이너스가 있어 갱신식은 플러스가 됩니다. 코드에서 부호를 하나 틀리면 θ가 바닥에서 점점 멀어지고 loss가 계속 커집니다. 학습할수록 loss가 커진다면 부호부터 확인하세요.
2는 빼도 되지만, 빼면 학습률의 의미가 바뀝니다
2α의 2를 지우고 θ + αx(y − ŷ)로 써도 학습은 됩니다. 다만 그 경우 같은 숫자의 α가 실제로는 절반 크기의 걸음이 됩니다. 다른 자료의 학습률 값을 그대로 가져올 때 이 차이로 결과가 달라질 수 있습니다.
바닥 근처에서 느려지는 것은 정상입니다
기울기에 오차 y − ŷ가 곱해져 있으므로, 정답에 가까워질수록 걸음이 저절로 작아집니다. 1편 그래프에서 θ가 3 근처에서 천천히 움직인 이유가 이것입니다.
딥러닝 경사하강법 갱신식 정리
- 경사하강법의 규칙은
θ ← θ − α · dL/dθ이고, 기울기의 반대 부호 쪽으로 움직이면 바닥에 가까워집니다. L = (y − θx)²를 미분하면dL/dθ = −2x(y − ŷ)이고, 대입하면θ ← θ + 2αx(y − ŷ)가 됩니다.- 수치 미분으로 확인한 결과, 유도한 기울기는 세 지점에서 모두 정확히 맞았습니다.
- 한 번 갱신할 때 남은 거리는
(1 − 2x²α)배가 되므로, 같은 학습률이라도 x가 클수록 빨리 배웁니다.
다음 글에서는 이 (1 − 2x²α)를 이용해, 학습률을 키우면 언제 진동하고 언제 발산하는지 실제 숫자로 확인합니다.
직접 해 보는 작은 실습
- 코드에서
th = th - lr * (...)의-를+로 바꿔 실행해 보세요. θ가 3에서 멀어지는 것을 확인할 수 있습니다. NumericGrad의h를1e-5에서1.0으로 키워 보세요. 이 loss는 이차식이라 중앙 차분 결과가 여전히 정확하게 나옵니다. 그다음 loss를(y − θx)⁴처럼 바꾸면 h가 클 때 수치 미분이 틀어지기 시작하는 것을 볼 수 있습니다.