기울기 하나짜리 선형회귀 모델을 C++로 학습시키며, 딥러닝의 예측·오차·갱신 반복이 실제로 어떻게 돌아가는지 실행 결과로 확인합니다.
딥러닝을 배우겠다고 마음먹고 첫 장을 펼쳤는데 신경망이 아니라 직선 긋기가 나오면 조금 맥이 빠집니다. 고등학교 때 배운 y = ax + b를 왜 다시 봐야 하는지 의문이 들기도 합니다. 그런데 딥러닝 선형회귀 모델을 C++로 직접 구현해 보면, 이 단순한 직선 안에 딥러닝 학습의 뼈대가 거의 그대로 들어 있다는 것을 알게 됩니다.
연재 안내: 전체 12편의 순서와 공개된 글은 딥러닝 수학 C++ 구현 로드맵에서 확인할 수 있습니다.
한 줄 답변
딥러닝이 선형회귀에서 시작하는 이유는 예측 → 오차 계산 → 기울기 계산 → 파라미터 갱신이라는 학습 반복이 거대한 신경망과 똑같으면서도, 파라미터가 하나뿐이라 그 과정을 눈으로 따라갈 수 있고, 정답을 미리 알기 때문에 학습이 맞게 됐는지 검증할 수 있기 때문입니다.
이 글에서 바로 답하는 것
- 딥러닝에서 말하는 “학습”이 정확히 어떤 계산인지
- 선형회귀가 딥러닝 공부의 출발점으로 좋은 이유 3가지
- C++로 학습시켰을 때 θ가 실제로 어떻게 변하는지
- 학습이 끝났는데 정답 3이 아니라 2.97이 나오는 이유
먼저 알아 둘 딥러닝 용어
본문에 들어가기 전에 이 글과 연재 전체에서 계속 나오는 용어를 정리합니다. 괄호 안은 영어 표현이고, 오른쪽 열은 이 글의 실험에서 그 용어가 가리키는 것입니다.
| 용어 | 뜻 | 이 글의 실험에서는 |
|---|---|---|
| 모델 (model) | 입력을 받아 예측값을 내는 계산식 | ŷ = θx |
| 파라미터 (parameter) | 모델 안에서 학습으로 바뀌는 값. “학습한다”는 곧 파라미터를 고친다는 뜻 | θ 하나 |
| 가중치 (weight) | 입력에 곱해지는 파라미터. 입력이 결과에 얼마나 크게 영향을 주는지 정함 | θ (직선의 기울기) |
| 바이어스 (bias) | 입력과 상관없이 더해지는 파라미터. 직선의 절편에 해당 | 없음 (7편에서 ŷ = θ1·x + θ0로 추가) |
| 샘플 (sample) | 입력과 정답 한 쌍 (x, y) | 100개 |
| 예측값 (prediction) | 모델이 내놓은 답. ŷ(와이 햇)으로 씀 | θ × x |
| 손실 (loss) | 샘플 하나에서 예측이 얼마나 틀렸는지 나타낸 숫자 | (y − ŷ)² |
| 비용 (cost) | 여러 샘플의 loss를 평균 낸 값 | 6편에서 자세히 다룸 |
| 기울기 (gradient) | 파라미터를 조금 바꿀 때 loss가 얼마나, 어느 방향으로 변하는지. 미분으로 구함 | −2x(y − ŷ) |
| 경사하강법 (gradient descent) | 기울기의 반대 방향으로 파라미터를 조금씩 옮겨 loss를 줄이는 방법 | θ 갱신식 |
| 학습률 (learning rate) | 한 번 갱신할 때 얼마나 크게 움직일지 정하는 값. α 또는 lr로 씀 | 0.001 |
| 갱신 (update, step) | 파라미터를 한 번 고치는 것. 반복(iteration)이라고도 함 | 총 5,000번 |
| 에폭 (epoch) | 전체 데이터를 처음부터 끝까지 한 번 다 쓰는 것 | 50 에폭 (1 에폭 = 100번 갱신) |
| 배치 (batch) | 한 번 갱신할 때 함께 쓰는 샘플 묶음 | 샘플 1개씩 (6편에서 비교) |
두 가지만 덧붙이면 다음과 같습니다.
- 가중치와 바이어스: 신경망에서는 수많은 가중치와 바이어스를 묶어서 그냥 “파라미터” 또는 “가중치”라고 부르는 경우가 많습니다. 이 글의 θ는 입력 x에 곱해지므로 가중치에 해당합니다. 바이어스는 통계에서 말하는 “편향(치우침)”과 영어 단어가 같지만, 딥러닝 모델 안에서는 더해지는 상수항을 뜻합니다.
- 에폭과 갱신 횟수: 샘플이 100개이고 샘플마다 한 번씩 고치면, 1 에폭에 100번 갱신합니다. 그래서 50 에폭은 5,000번 갱신입니다. 그래프의 가로축이 “갱신 횟수”인지 “에폭”인지에 따라 같은 학습도 다르게 보이므로 항상 단위를 확인해야 합니다.
딥러닝 선형회귀 실험: 정답이 3인 문제
먼저 정답을 알고 있는 문제를 하나 만듭니다. 입력 x를 무작위로 100개 뽑고, 정답 y는 3x에 약간의 잡음을 더해 만듭니다.
- 데이터:
y = 3x + 0.5 × (표준정규분포 잡음), 샘플 100개 - 모델:
ŷ = θx(절편 없이 기울기 θ 하나만 있는 모델) - 시작값:
θ = 0.1(정답 3과 일부러 멀리 떨어뜨림)
모델은 정답이 3이라는 사실을 모릅니다. 데이터만 보고 θ를 스스로 3 근처로 옮겨 갈 수 있는지가 이 실험의 질문입니다.
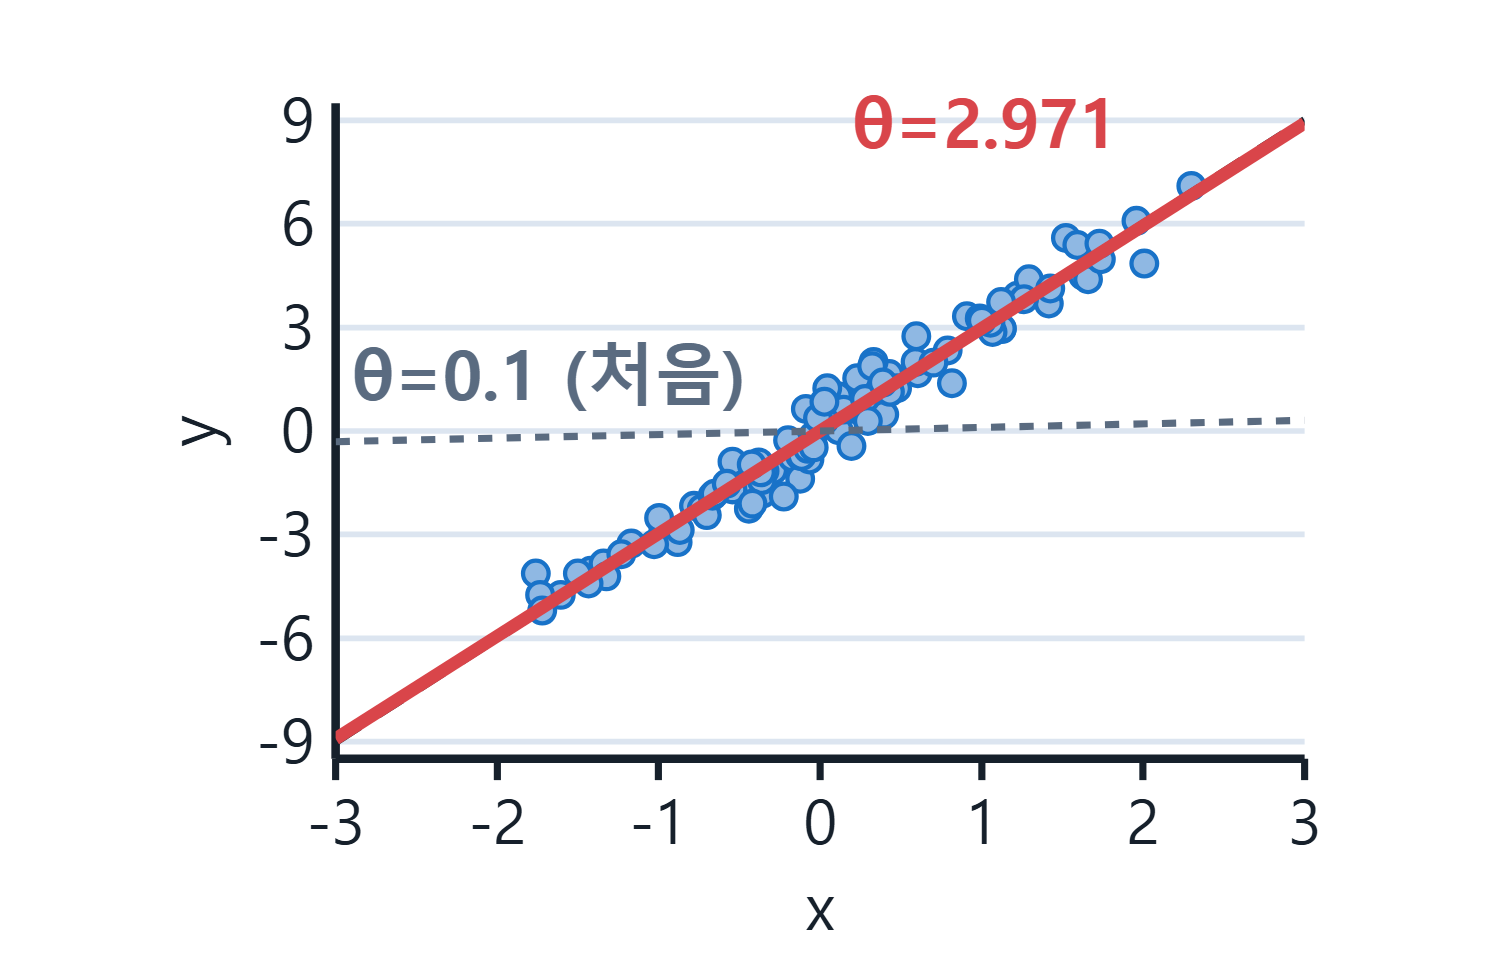
처음 직선(점선, θ=0.1)은 거의 수평이라 데이터를 전혀 설명하지 못합니다. 학습이 끝난 직선(빨간 선, θ=2.971)은 데이터 한가운데를 지나갑니다. 이 글은 점선이 빨간 선으로 바뀌는 동안 무슨 일이 일어났는지를 다룹니다.
학습은 이 네 단계의 반복입니다
샘플 하나 (x, y)가 들어올 때마다 모델은 다음 네 단계를 거칩니다.
- 예측: 지금의 θ로
ŷ = θx를 계산합니다. - 오차 계산: 예측이 얼마나 틀렸는지
loss = (y − ŷ)²로 잽니다. 차이를 제곱하므로 많이 틀릴수록 loss가 크게 커집니다. - 기울기 계산: θ를 조금 키우면 loss가 커지는지 작아지는지를 미분으로 확인합니다.
- 갱신: loss가 작아지는 방향으로 θ를 조금 옮깁니다.
이 네 단계를 정리하면 θ를 바꾸는 식은 한 줄이 됩니다.
θ ← θ + 2 · α · x · (y − ŷ)여기서 α(학습률)는 한 번에 얼마나 크게 움직일지 정하는 값입니다. 이 식이 어떻게 나오는지는 2편(경사하강법 갱신식, 미분 한 번으로 유도)에서 자세히 다룹니다. 지금은 틀린 만큼(y − ŷ), 입력 크기(x)에 비례해서 θ를 고친다는 뜻으로만 읽어도 충분합니다.
C++와 파이썬 코드로 나란히 보기
위의 네 단계를 코드로 옮겨 보겠습니다. 같은 계산을 C++와 파이썬으로 나란히 적었습니다. 데이터를 만드는 부분과 학습하는 부분으로 나뉘고, 학습 부분의 핵심은 두 언어 모두 세 줄입니다.
C++ (C++17, 외부 라이브러리 없음)
#include <iostream>
#include <random>
#include <vector>

int main() {
    // 데이터 만들기: y = 3x + 0.5 * 잡음
    std::mt19937 rng(0);                                   // 난수 시드 고정
    std::normal_distribution<double> normal(0.0, 1.0);
    const std::size_t n_sample = 100;
    std::vector<double> x_data(n_sample), y_data(n_sample);
    for (auto& x : x_data) x = normal(rng);                // x ~ N(0, 1)
    for (std::size_t i = 0; i < n_sample; ++i)
        y_data[i] = 3.0 * x_data[i] + 0.5 * normal(rng);   // y = 3x + 잡음

    // 학습
    double th = 0.1;                                       // 시작값 (정답 3과 멀리)
    const double lr = 0.001;                               // 학습률
    for (std::size_t epoch = 0; epoch < 50; ++epoch) {     // 전체 데이터를 50바퀴
        for (std::size_t i = 0; i < n_sample; ++i) {
            const double x = x_data[i], y = y_data[i];
            const double pred = th * x;                    // 1) 예측
            [[maybe_unused]] const double loss = (y - pred) * (y - pred);  // 2) 오차
            th = th + 2.0 * x * lr * (y - pred);           // 3)+4) 기울기 계산과 갱신
        }
    }
    std::cout << "learned th = " << th << 'n';
}
Python (NumPy)
import numpy as np

# 데이터 만들기: y = 3x + 0.5 * 잡음
np.random.seed(0)                                       # 난수 시드 고정
n_sample = 100
x_data = np.random.randn(n_sample)                      # x ~ N(0, 1)
y_data = 3 * x_data + 0.5 * np.random.randn(n_sample)   # y = 3x + 잡음

# 학습
th = 0.1                                                # 시작값 (정답 3과 멀리)
lr = 0.001                                              # 학습률
for epoch in range(50):                                 # 전체 데이터를 50바퀴
    for x, y in zip(x_data, y_data):
        pred = th * x                                   # 1) 예측
        loss = (y - pred) ** 2                          # 2) 오차
        th = th + 2 * x * lr * (y - pred)               # 3)+4) 기울기 계산과 갱신

print("learned th =", th)
두 코드를 나란히 보면 학습 부분은 문법만 다를 뿐 한 줄 한 줄이 그대로 대응합니다. 라이브러리 호출은 하나도 없고, 곱셈·뺄셈·덧셈뿐입니다. 거대한 신경망도 이 반복문의 구조는 같습니다. 파라미터가 θ 하나가 아니라 수십억 개이고, 기울기를 손으로 쓴 식 대신 역전파로 계산한다는 점만 다릅니다. C++ 코드의 [[maybe_unused]]는 loss를 계산해 보여 주기만 하고 쓰지는 않는다는 표시로, 컴파일러의 “쓰지 않는 변수” 경고를 막아 줍니다.
차이는 데이터를 만드는 부분에서 생깁니다. 파이썬은 np.random.randn 한 줄로 배열을 채우지만, C++는 난수 엔진(std::mt19937)과 분포(std::normal_distribution)를 따로 만들고 반복문으로 하나씩 채워야 합니다. 그리고 두 언어는 난수를 뽑는 알고리즘이 달라서, 같은 시드 0을 써도 만들어지는 데이터가 다릅니다.
| 실행 | 데이터 | 학습된 θ |
|---|---|---|
| C++ | C++ 난수(mt19937, 시드 0) | 2.97091 |
| Python | NumPy 난수(시드 0) | 3.06161 |
| Python | C++가 만든 데이터를 그대로 읽어 학습 | 2.97091 |
파이썬에서 나온 3.06161은 틀린 값이 아니라 다른 데이터 100개로 학습한 결과입니다. 그 데이터의 최소제곱 해도 3.05955로, 학습이 역시 그 근처로 찾아갔습니다. 반대로 C++가 만든 데이터를 파이썬에 그대로 넣으면 결과가 2.97091로 똑같이 나옵니다. 언어가 달라도 학습 계산은 같다는 뜻입니다.
이 글의 아래 결과와 그래프는 C++ 실행 결과를 기준으로 합니다.
실제로 돌려 보면
샘플 100개를 50바퀴(epoch), 총 5,000번 갱신한 결과입니다.
| 항목 | 값 |
|---|---|
| 시작 θ | 0.1 |
| 학습이 끝난 θ | 2.97091 |
| 정답 | 3 |
| |θ − 3| < 0.1에 처음 도달 | 2,100번째 갱신 (22번째 epoch) |
| 마지막 epoch의 평균 loss | 0.2622 |
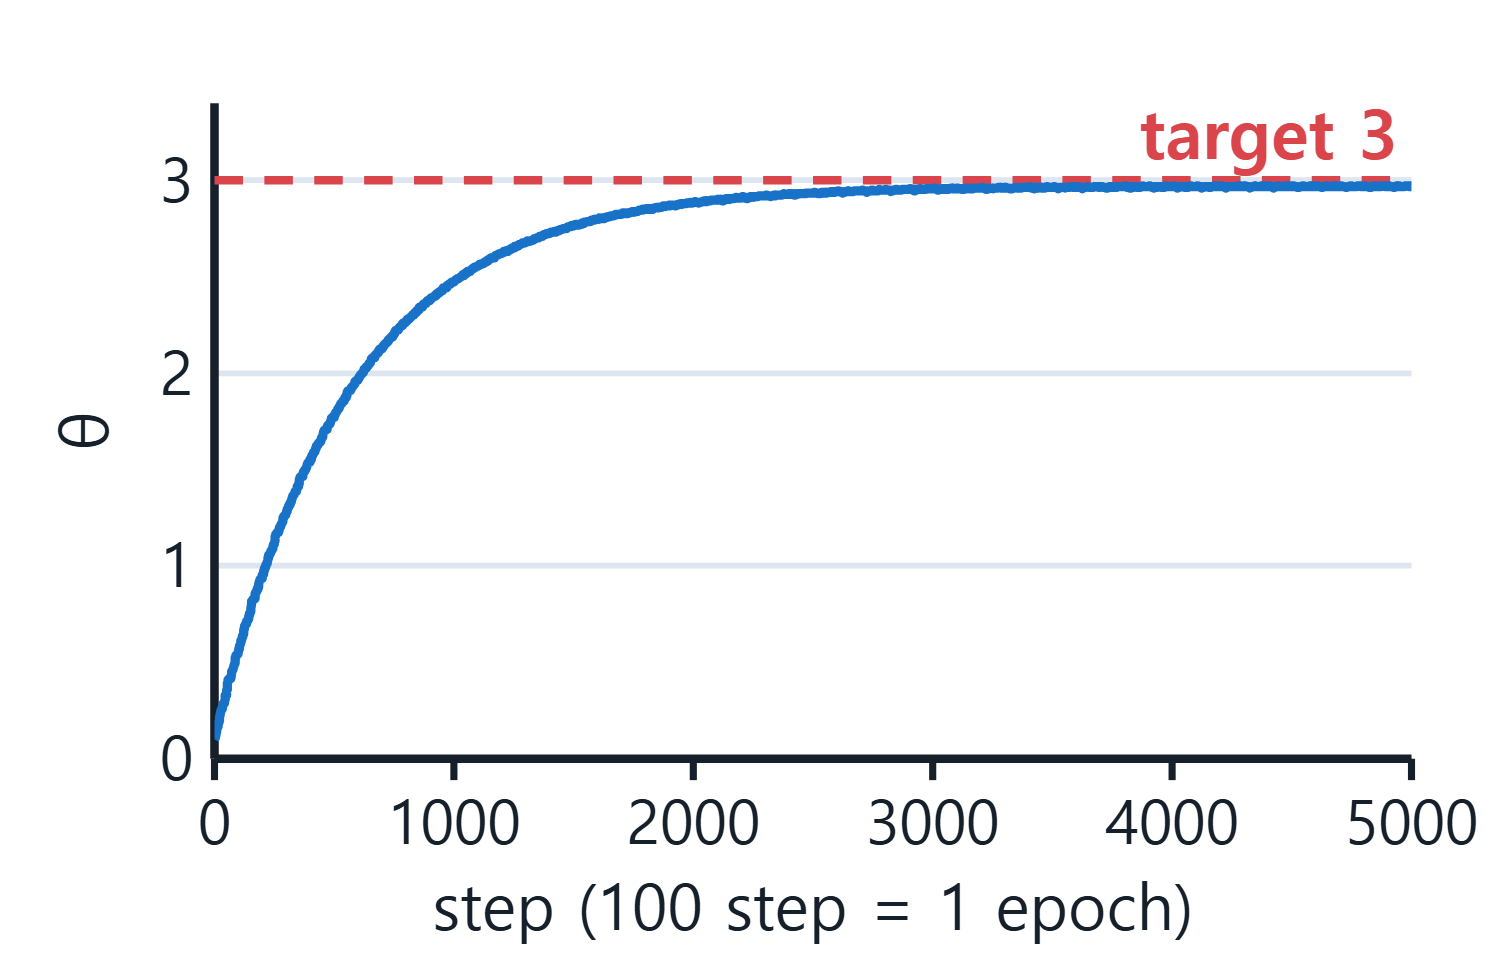
처음에는 θ가 빠르게 올라가다가 3에 가까워질수록 점점 천천히 움직입니다. 정답에서 멀 때는 오차 (y − ŷ)가 커서 한 번에 많이 고치고, 정답에 가까워지면 오차가 작아져 조금씩만 고치기 때문입니다. 누가 “이제 천천히 가라”고 정해 준 것이 아니라, 갱신식 자체가 그렇게 움직이도록 생겼습니다.
이유 1. 신경망과 같은 학습 반복을 가장 작게 볼 수 있습니다
앞의 코드에서 본 예측 → 오차 → 기울기 → 갱신 반복은 딥러닝 모델 대부분이 쓰는 학습 방식과 같은 구조입니다. 이미지 분류 모델도, 언어 모델도 결국 “지금 파라미터로 예측하고, 얼마나 틀렸는지 재고, 덜 틀리는 방향으로 파라미터를 조금 옮기는 일”을 아주 많이 반복합니다.
선형회귀는 이 반복에서 모델 부분만 가장 단순하게 줄인 형태입니다. 그래서 여기서 반복 구조를 확실히 이해해 두면, 나중에 모델이 복잡해져도 “모델 부분이 바뀌었을 뿐 학습 방식은 같다”는 것이 보입니다.
이유 2. 오차 지형이 포물선이라 눈으로 따라갈 수 있습니다
샘플 하나만 놓고 보면 loss는 θ에 대한 이차함수, 즉 포물선입니다. 바닥이 하나뿐이라 어느 쪽으로 가야 할지 헷갈릴 일이 없습니다.
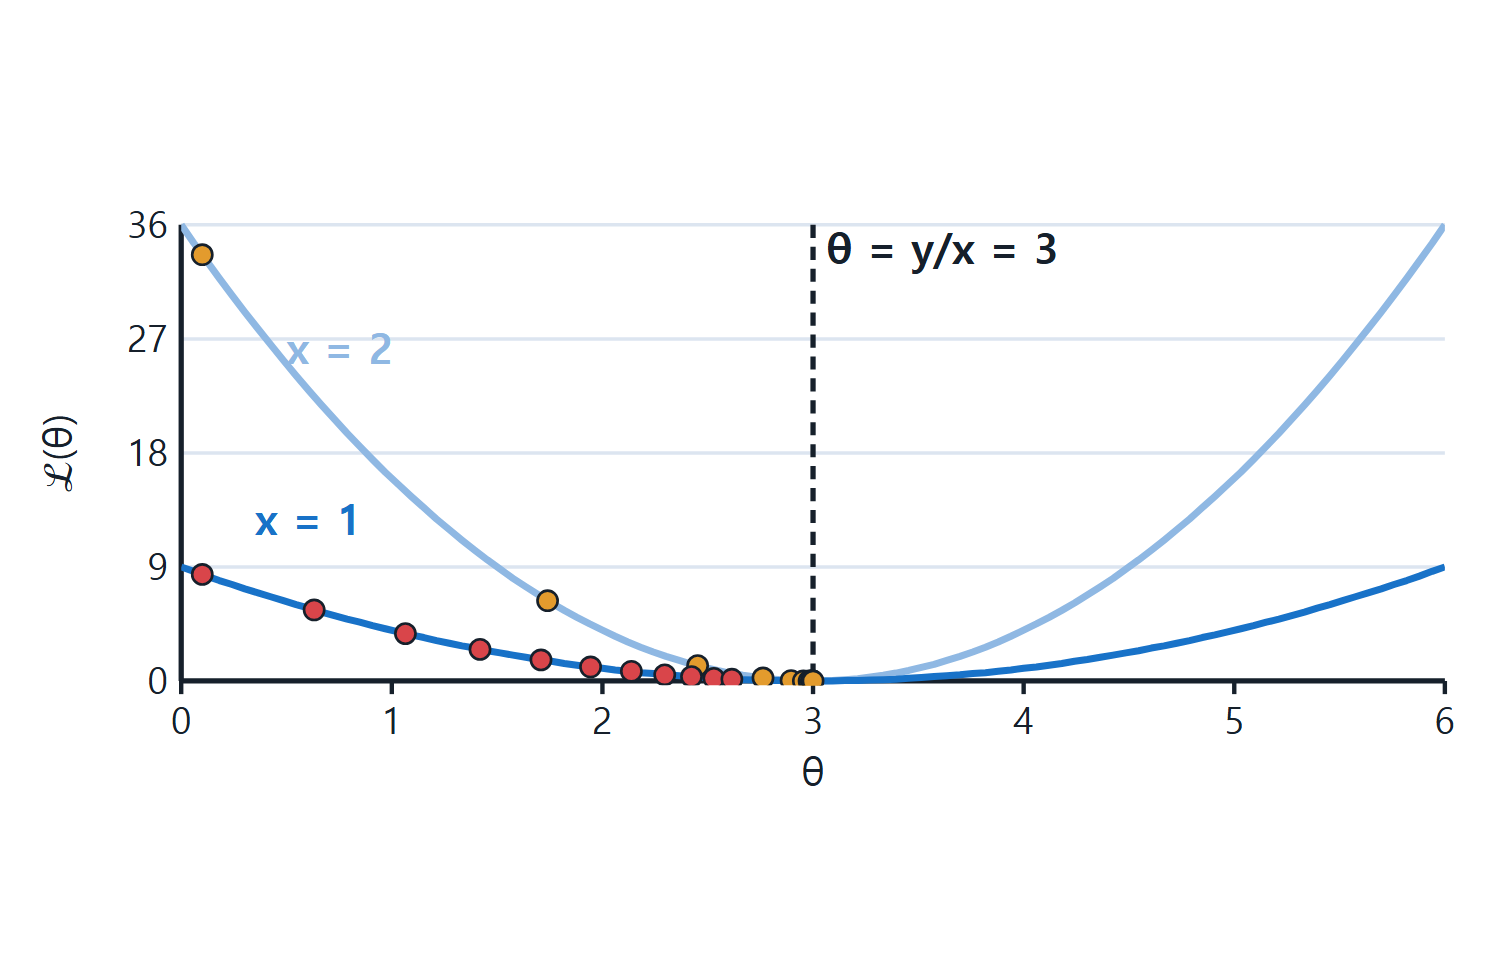
그림의 두 포물선은 y = 3x를 만족하는 샘플 하나(x=1과 x=2)의 loss입니다. 둘 다 θ = 3에서 바닥(loss 0)에 닿습니다. 빨간 점(x=1)과 주황 점(x=2)은 학습률 0.01로 갱신할 때 10번마다 찍은 θ의 위치입니다. 비탈이 가파른 x=2 쪽이 훨씬 빨리 바닥에 닿습니다. 실제로 θ가 3과 0.01 이내로 가까워지기까지 x=1은 281번, x=2는 68번 갱신이 필요했습니다.
손으로 첫 네 번을 계산해 보면 이렇습니다(x = 1, y = 3, 학습률 0.01).
| 갱신 | θ | 예측 ŷ | loss | 기울기 | 다음 θ |
|---|---|---|---|---|---|
| 0 | 0.1000 | 0.1000 | 8.4100 | −5.8000 | 0.1580 |
| 1 | 0.1580 | 0.1580 | 8.0770 | −5.6840 | 0.2148 |
| 2 | 0.2148 | 0.2148 | 7.7571 | −5.5703 | 0.2705 |
| 3 | 0.2705 | 0.2705 | 7.4499 | −5.4589 | 0.3251 |
기울기가 음수라는 것은 “θ를 키우면 loss가 줄어든다”는 뜻이므로 θ가 커집니다. 그리고 정답까지 남은 거리 3 − θ는 매번 정확히 0.98배로 줄어듭니다. 이 0.98이라는 숫자가 학습 속도와 발산 여부를 정하는 열쇠이고, 3편(학습률)에서 다시 만나게 됩니다.
파라미터가 수십억 개인 모델에서는 이런 지형을 그림으로 그릴 수 없습니다. 선형회귀에서는 그릴 수 있기 때문에 “경사를 따라 내려간다”는 말이 비유가 아니라 실제 그림이 됩니다.
이유 3. 정답을 알기 때문에 검증할 수 있습니다
실제 문제에서는 정답 파라미터를 모릅니다. 그래서 학습이 잘 안 될 때, 코드가 틀린 것인지 데이터가 어려운 것인지 구분하기 어렵습니다. 이 실험은 정답이 3이라는 것을 알고 만들었기 때문에 결과를 바로 확인할 수 있습니다.
그런데 학습된 θ는 3이 아니라 2.97091이었습니다. 이것은 실패일까요?
같은 데이터로 수학적으로 가장 잘 맞는 기울기(최소제곱 해, Σxy / Σx²)를 직접 계산하면 2.96927이 나옵니다. 잡음이 섞인 데이터 100개만 보면 “이 데이터에 가장 잘 맞는 기울기”는 3보다 조금 작습니다. 학습은 이 값 근처로 정확히 찾아갔습니다. 3과의 차이는 학습의 잘못이 아니라 데이터에 섞인 잡음 때문입니다.
이렇게 정답과 비교할 기준이 있어야 “학습이 맞게 됐다”를 숫자로 말할 수 있습니다. 선형회귀가 처음 공부하기 좋은 또 하나의 이유입니다.
결과를 잘못 읽기 쉬운 세 가지
loss가 0이 되지 않는다고 학습 실패가 아닙니다
마지막 epoch의 평균 loss는 0.2622였습니다. 데이터를 만들 때 넣은 잡음의 분산이 0.5² = 0.25이므로, 아무리 학습을 잘해도 loss는 이 근처 아래로 내려갈 수 없습니다. “loss가 더 안 줄어든다”는 것이 곧 “학습이 실패했다”는 뜻은 아닙니다.
학습이 끝나도 θ는 조금씩 흔들립니다
이 실험은 샘플 하나마다 θ를 고치기 때문에, 마지막 epoch 동안에도 θ는 2.9627~2.9730 사이에서 계속 움직였습니다. 샘플마다 조금씩 다른 방향으로 당기기 때문입니다. 이 흔들림을 줄이는 방법이 6편(Batch, SGD, Mini-batch)의 주제입니다.
학습률을 키운다고 무조건 빨라지지는 않습니다
이 실험의 학습률 0.001은 안전하지만 느립니다. 3 근처(오차 0.1 이내)에 도달하는 데 22 epoch이 걸렸습니다. 학습률을 키우면 빨라지지만, 어느 선을 넘으면 θ가 바닥을 지나쳐 오히려 멀어집니다. 그 경계가 어디인지는 3편에서 실제 숫자로 확인합니다.
정리
- 딥러닝의 학습은 예측 → 오차 → 기울기 → 갱신의 반복이고, 선형회귀는 이 반복을 가장 작게 보여 줍니다.
- 파라미터가 하나이고 오차 지형이 포물선이라, 학습 과정을 그림과 숫자로 끝까지 따라갈 수 있습니다.
- 정답을 알고 시작하기 때문에 결과를 검증할 수 있고, 2.97이라는 값이 “데이터에 가장 잘 맞는 값”이라는 것도 확인할 수 있습니다.
다음 글에서는 오늘 그대로 받아들였던 갱신식 θ ← θ + 2αx(y − ŷ)가 어디서 나오는지, 미분 한 번으로 직접 유도해 보겠습니다.
직접 해 보는 작은 실습
코드를 실행할 수 있다면 두 가지만 바꿔 보세요.
- 시작값을
θ = 0.1대신θ = 6.0으로 바꿉니다. 이번에는 θ가 위에서 아래로 내려오면서 같은 값 근처에 도착하는지 확인해 보세요. - 잡음 크기 0.5를 0으로 바꿉니다. 그러면 최소제곱 해가 정확히 3이 되고, 학습된 θ도 3에 아주 가까워지는지 확인해 보세요.
두 실험 모두 결과가 예상대로 나오면, 학습이 “정답을 아는 것”이 아니라 “데이터가 가리키는 바닥으로 내려가는 것”이라는 점을 직접 확인한 셈입니다.