같은 모델, 같은 학습률인데 입력 데이터의 평균과 표준편차만 바꿔도 학습이 느려지거나 발산합니다. 딥러닝 데이터 분포와 학습률의 관계를 E[x²] 하나로 설명합니다.
모델 코드도 같고 학습률도 같은데, 데이터만 바꿨더니 학습이 안 되는 경우가 있습니다. 코드를 아무리 들여다봐도 틀린 곳이 없습니다. 원인은 데이터 쪽에 있습니다. 이번 글에서는 딥러닝 데이터 분포, 즉 입력값이 어떤 평균과 퍼짐을 가지는지가 학습을 어떻게 바꾸는지 실험으로 확인합니다.
연재 안내: 전체 12편의 순서와 공개된 글은 딥러닝 수학 C++ 구현 로드맵에서 확인할 수 있습니다. 이 글은 3편: 학습률의 배수
f = 1 − 2x²α를 그대로 사용합니다.
한 줄 답변
3편에서 본 것처럼 한 번 갱신할 때의 배수는 1 − 2x²α라서, 학습이 안정적인지는 x²의 크기가 정합니다. x의 평균이 μ, 표준편차가 σ이면 x²의 평균은 E[x²] = μ² + σ²입니다(정규분포가 아니어도 성립합니다). 그래서 표준편차가 커지거나 평균이 0에서 멀어지면(양수든 음수든) 같은 학습률로도 발산하고, 알맞은 학습률은 대략 1/(2·E[x²]) 근처로 작아집니다.
이 글에서 바로 답하는 것
- 같은 학습률인데 데이터 분포만 바꾸면 왜 결과가 달라지는지
- 표준편차와 평균이 각각 학습에 어떤 영향을 주는지
- 평균이 +15인 데이터와 −15인 데이터가 왜 똑같이 위험한지
- 데이터의 분포를 보고 학습률을 어림하는 방법
이 글에 나오는 용어
| 용어 | 뜻 |
|---|---|
| 분포 (distribution) | 데이터 값들이 어디에 얼마나 모여 있는지의 모양 |
정규분포 N(μ, σ²) | 평균 μ를 중심으로 좌우 대칭인 종 모양 분포. σ는 표준편차 |
| 평균 (mean, μ) | 값들의 중심 위치 |
| 표준편차 (standard deviation, σ) | 값들이 평균에서 얼마나 넓게 퍼져 있는지 |
E[x²] | x²의 평균(기댓값). 평균 μ, 표준편차 σ인 분포라면 μ² + σ² |
| 합성 데이터 (synthetic data) | 정답을 미리 정해 두고 일부러 만든 데이터. 학습이 정답에 가는지 검증할 때 씀 |
실험 설계: 정답이 1인 데이터
이번에는 정답을 y = x, 즉 θ = 1로 정합니다. 1편과 같은 모델 ŷ = θx이고, 시작값은 θ = 0.1입니다. 바꾸는 것은 입력 x를 뽑는 분포뿐입니다.
데이터가 y = x이면 3편의 유도를 그대로 따라 한 번 갱신할 때 다음이 성립합니다.
θ_new − 1 = (1 − 2αx²)(θ − 1)정답만 3에서 1로 바뀌었을 뿐 배수는 같습니다. 이 배수에 x²이 들어 있으므로, x를 어떤 분포에서 뽑느냐가 곧 배수를 정합니다.
왜 x²의 평균이 μ² + σ²일까
x를 “평균 μ + 평균에서 벗어난 정도 d”로 나누어 보면 x² = μ² + 2μd + d²입니다. 여기서 d는 평균이 0이므로 가운데 항 2μd의 평균은 0이 되고, d²의 평균은 분산 σ²입니다.
E[x²] = μ² + σ²이 식에서 두 가지를 읽을 수 있습니다.
- σ가 커지면: 가끔 아주 큰 |x|가 나와서 x²이 커지고, 그 샘플에서 한 번의 갱신이 크게 튑니다.
- |μ|가 커지면: 모든 x가 0에서 멀리 있어서 x²이 항상 큽니다. μ가 제곱으로 들어가므로 +15와 −15는 똑같이 위험합니다.
C++와 파이썬 코드로 확인하기
두 언어의 난수 생성기는 같은 시드에서도 다른 값을 만들기 때문에(1편 참고), 이번에는 난수 대신 표준정규분포에서 뽑은 것처럼 고른 값 10개를 고정해서 씁니다. 이 10개에 x = μ + σ × z를 적용하면 원하는 분포를 흉내 낼 수 있고, 두 언어의 출력도 완전히 같아집니다.
학습률은 0.008로 고정하고, 10개 샘플을 10 epoch(100번 갱신) 학습합니다. 함께 출력하는 epoch f는 3편에서 본 “1 epoch 동안 샘플별 배수를 곱한 값”입니다. 이 값의 절댓값이 1보다 작으면 수렴하고, 크면 발산합니다.
C++ (C++17, 외부 라이브러리 없음)
#include <cstdio>
#include <utility>
#include <vector>

double Train(const std::vector<double>& xs, double lr, int epochs, double th = 0.1) {
    for (int epoch = 0; epoch < epochs; ++epoch)
        for (double x : xs) {
            const double y = x;                          // 정답은 y = x, 즉 θ = 1
            th = th + 2.0 * x * lr * (y - th * x);       // 2편 갱신식
        }
    return th;
}

int main() {
    // 표준정규분포에서 뽑은 것처럼 고른 값 10개 (평균 0, 표준편차 약 0.94)
    const std::vector<double> z = {-1.6, -1.1, -0.7, -0.4, -0.1, 0.1, 0.4, 0.7, 1.1, 1.6};
    const double lr = 0.008;
    const std::vector<std::pair<double, double>> settings = {
        {0, 1}, {0, 2}, {0, 5}, {0, 10}, {0, 15}, {5, 1}, {15, 1}, {-15, 1}};

    for (const auto& [mean, std_dev] : settings) {
        std::vector<double> xs;
        for (double v : z) xs.push_back(mean + std_dev * v);   // x ~ N(mean, std^2) 흉내

        double ex2 = 0.0, epoch_f = 1.0;
        for (double x : xs) {
            ex2 += x * x;                                // x^2의 평균을 구하려고 합산
            epoch_f *= 1.0 - 2.0 * lr * x * x;           // 3편의 배수를 1 epoch 동안 곱한 값
        }
        ex2 /= xs.size();

        char label[32];
        std::snprintf(label, sizeof(label), "N(%g,%g^2)", mean, std_dev);
        std::printf("%-11sE[x^2]=%7.2f  epoch f=%+10.3g  th=%.6gn", label, ex2, epoch_f,
                    Train(xs, lr, 10));
    }
}
Python (표준 라이브러리만 사용)
# 표준정규분포에서 뽑은 것처럼 고른 값 10개 (평균 0, 표준편차 약 0.94)
z = [-1.6, -1.1, -0.7, -0.4, -0.1, 0.1, 0.4, 0.7, 1.1, 1.6]

def train(xs, lr, epochs, th=0.1):
    for _ in range(epochs):
        for x in xs:
            y = x                                  # 정답은 y = x, 즉 θ = 1
            th = th + 2 * x * lr * (y - th * x)    # 2편 갱신식
    return th

lr = 0.008
for mean, std in [(0, 1), (0, 2), (0, 5), (0, 10), (0, 15), (5, 1), (15, 1), (-15, 1)]:
    xs = [mean + std * v for v in z]               # x ~ N(mean, std^2) 흉내
    ex2 = sum(x * x for x in xs) / len(xs)         # x^2의 평균
    epoch_f = 1.0
    for x in xs:
        epoch_f *= 1 - 2 * lr * x * x              # 3편의 배수를 1 epoch 동안 곱한 값
    th = train(xs, lr, 10)
    print(f"N({mean},{std}^2)".ljust(11) + f"E[x^2]={ex2:7.2f}  epoch f={epoch_f:+10.3g}  th={th:.6g}")
실행 결과
N(0,1^2)   E[x^2]=   0.89  epoch f=    +0.866  th=0.786622
N(0,2^2)   E[x^2]=   3.54  epoch f=    +0.546  th=0.997871
N(0,5^2)   E[x^2]=  22.15  epoch f= +8.62e-05  th=1
N(0,10^2)  E[x^2]=  88.60  epoch f=     +0.21  th=1
N(0,15^2)  E[x^2]= 199.35  epoch f=     +74.1  th=-4.51456e+18
N(5,1^2)   E[x^2]=  25.89  epoch f=  +0.00324  th=1
N(15,1^2)  E[x^2]= 225.89  epoch f= +1.28e+04  th=-1.05987e+41
N(-15,1^2) E[x^2]= 225.89  epoch f= +1.28e+04  th=-1.05987e+41
결과 읽기
표준편차를 키울 때: 느림 → 빠름 → 발산
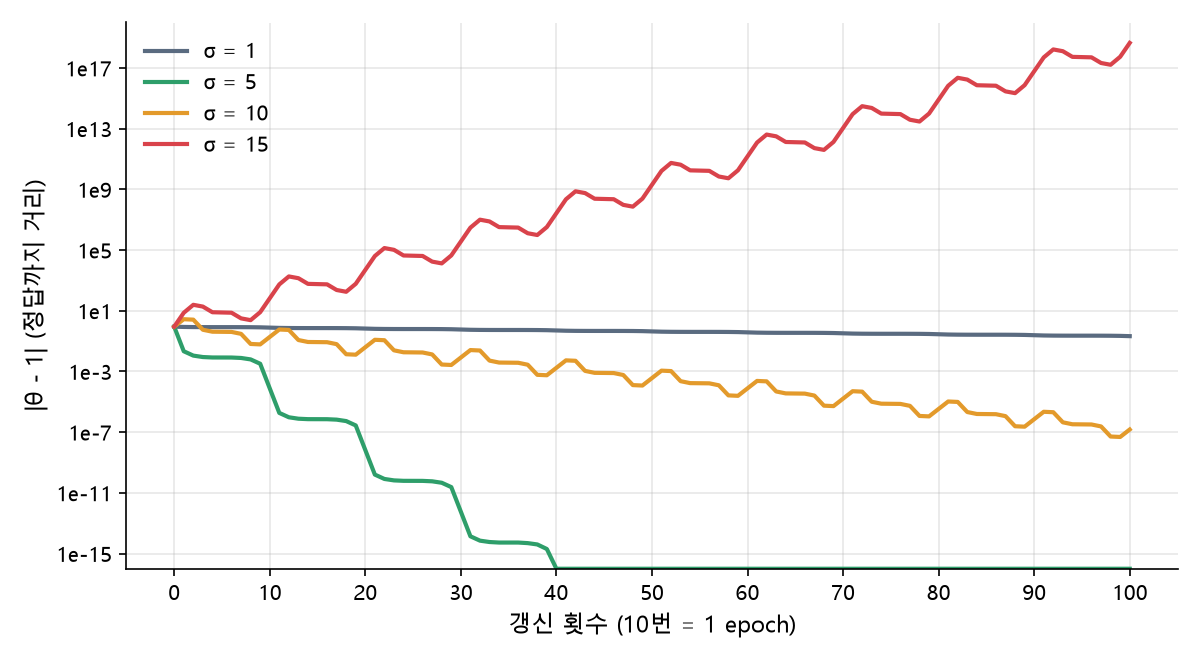
- σ = 1:
E[x²]가 0.89로 작아서 한 번에 조금씩만 움직입니다. 100번 갱신해도 0.786622로, 정답 1에 한참 못 미칩니다. 학습률 0.008이 이 데이터에는 너무 작은 것입니다. - σ = 5: 가장 빠릅니다. 1 epoch마다 거리가 약 1만분의 1로 줄어 40번 만에 컴퓨터가 구분할 수 없을 만큼 1에 닿았습니다.
- σ = 10: 수렴은 했지만 그래프가 epoch 안에서 출렁입니다. 가장 큰 x(16)에서는 샘플 하나의 배수가 −3.1이라 그 순간 거리가 커지고, 나머지 샘플이 다시 줄여 주는 모양입니다.
- σ = 15: 큰 x가 만드는 튐을 나머지 샘플이 더는 감당하지 못해, 1 epoch마다 거리가 74배씩 커지며 발산했습니다.
같은 학습률 0.008이 σ = 1에서는 너무 작고, σ = 15에서는 너무 큽니다. 학습률의 “적당함”은 데이터 분포에 따라 달라집니다.
평균을 0에서 멀리 옮길 때
평균 5(E[x²] = 25.89)는 빠르게 수렴했지만, 평균 15(E[x²] = 225.89)는 발산했습니다. 그리고 평균 +15와 −15의 결과가 완전히 같습니다. 갱신식에서 x는 x²의 형태로만 배수에 들어가므로, 부호가 바뀌어도 학습은 똑같이 흘러갑니다(이 실험의 고정값 z는 0을 중심으로 대칭이라, 두 데이터의 x² 값이 순서만 다르고 같습니다). “음수 데이터라서 괜찮겠지”는 통하지 않습니다.
평균 15는 표준편차가 1밖에 안 되는데도 발산했다는 점도 중요합니다. 값이 좁게 모여 있어도 0에서 멀리 떨어져 있으면 모든 샘플의 x²이 크기 때문입니다.
무작위 데이터로 해도 결론은 같습니다
위 실험은 값을 고정했지만, C++ 원본 예제에서는 실제 난수로 샘플 100개를 뽑아 학습률 0.008로 1 epoch 학습했습니다. 표의 값은 학습 기록에 남은 마지막 θ입니다.
| 분포 | 마지막 θ | 결과 |
|---|---|---|
| N(0, 1) | 0.773985 | 느림 |
| N(0, 5²) | 1 | 수렴 |
| N(0, 10²) | 1 | 수렴 |
| N(0, 15²) | −1.39732e+13 | 발산 |
| N(15, 1) | 2.08467e+41 | 발산 |
| N(−15, 1) | 8.61398e+39 | 발산 |
샘플이 무작위라 +15와 −15의 숫자는 다르게 나왔지만, 둘 다 발산한다는 결론은 같습니다.
같은 예제에서 분포마다 학습률 후보 12개(0.0001~0.5)를 시험해 가장 빨리 θ가 1 근처(오차 0.001 이내)에 들어가 머문 학습률도 찾았습니다.
| 분포 | E[x²] | 가장 빨랐던 학습률 | 이론값 1/(2·E[x²]) |
|---|---|---|---|
| N(0, 1) | 1 | 0.2 | 0.5 |
| N(0, 3²) | 9 | 0.02 | 0.056 |
| N(−3, 2²) | 13 | 0.05 | 0.038 |
| N(5, 1) | 26 | 0.02 | 0.019 |
| N(10, 5²) | 125 | 0.002 | 0.004 |
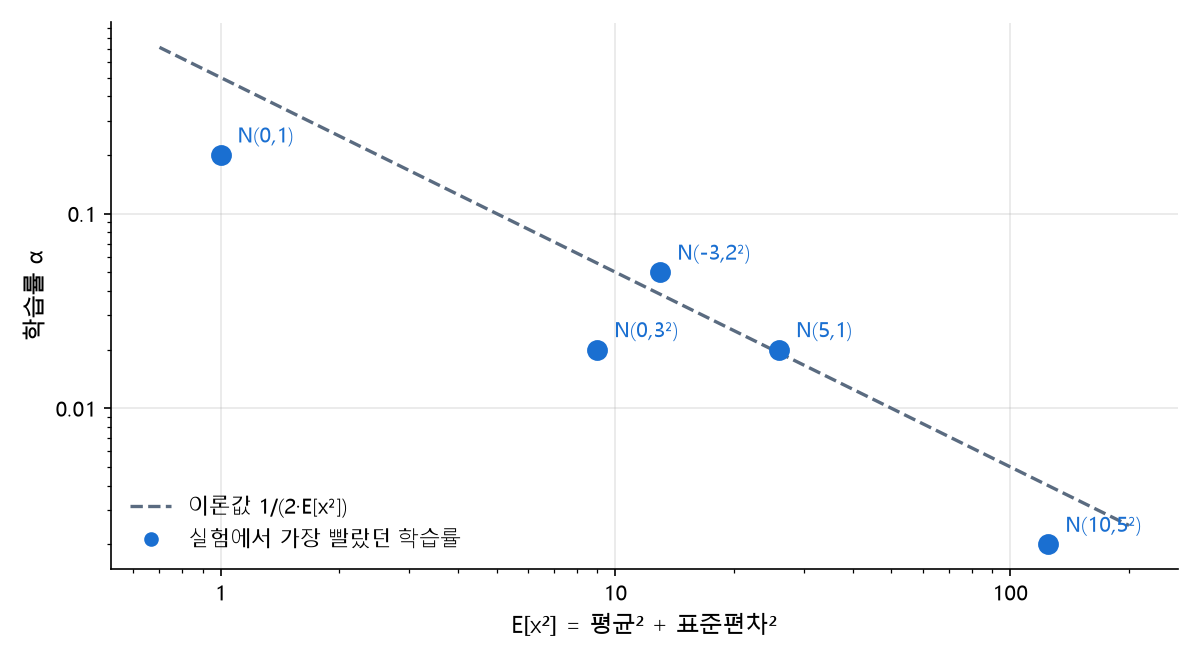
점들이 이론선과 정확히 겹치지는 않습니다. 후보 학습률이 띄엄띄엄 있고, 실제 샘플의 x²은 평균값 하나로 정해지지 않기 때문입니다. 그래도 E[x²]가 10배 커지면 알맞은 학습률은 대략 10분의 1로 작아진다는 흐름은 분명합니다.
실전에서 기억할 것
- 학습 전에 입력의 평균과 표준편차를 확인합니다. 몇 줄이면 계산할 수 있고, 학습률을 어디서부터 시도할지 알려 줍니다.
1/(2·E[x²])을 출발점으로 삼습니다. 정확한 답은 아니지만 자릿수는 맞습니다. 여기서부터 몇 배씩 줄이거나 키워 봅니다.- 입력이 여러 개면 가장 큰 쪽이 학습률을 묶습니다. 키(170 근처)와 시력(1 근처)을 함께 입력하면, 키에 맞춰 학습률을 줄여야 하고 시력 쪽 학습은 아주 느려집니다.
- 분포를 바꾸는 쪽이 근본 해결입니다. 학습률을 데이터마다 맞추는 대신 입력을 평균 0, 표준편차 1 근처로 바꾸면 같은 학습률로 안정적으로 학습할 수 있습니다. 이것이 10편의 Feature Scaling입니다.
흔히 헷갈리는 부분
“값이 좁게 모여 있으면 안전하다”는 틀릴 수 있습니다
평균 15, 표준편차 1인 데이터는 아주 좁게 모여 있지만 발산했습니다. 위험을 정하는 것은 퍼짐(σ)만이 아니라 μ² + σ² 전체입니다.
학습이 느린 것도 분포 탓일 수 있습니다
σ = 1에서 θ가 0.79에 머문 것은 학습률이 이 데이터에 비해 너무 작았기 때문입니다. “모델이 못 배운다”고 판단하기 전에 학습률과 입력 크기의 관계부터 확인하세요.
이 글의 공식은 1차원 선형회귀에서 정확합니다
1/(2·E[x²])은 이 글의 모델에서 유도한 값입니다. 복잡한 신경망에서는 이 숫자를 그대로 쓸 수 없지만, “입력이 클수록 학습률을 줄여야 한다”는 원리는 그대로 적용됩니다.
딥러닝 데이터 분포 정리
- 갱신 배수
1 − 2αx²에 x²이 들어 있으므로, 입력 분포가 학습의 안정성을 정합니다. - 정규분포에서
E[x²] = μ² + σ²이라, 표준편차가 커지거나 평균이 0에서 멀어지면 같은 학습률로도 발산합니다. - 평균의 부호는 상관없습니다. +15와 −15는 똑같이 위험합니다.
- 알맞은 학습률은 대략
1/(2·E[x²])에 비례해 작아지며, 근본적인 해결책은 입력을 일정한 크기로 맞추는 Feature Scaling입니다.
다음 글에서는 지금까지처럼 샘플 하나마다 갱신하는 방식(SGD)과, 전체를 모아서 갱신하는 Batch, 그 중간인 Mini-batch를 비교합니다.
직접 해 보는 작은 실습
- 학습률을 0.008에서 0.002로 줄여 다시 실행해 보세요.
N(0,15²)는E[x²]가 약 200이라 이론값이1/(2×200) = 0.0025입니다. 그 근처인 0.002에서는 발산하던 데이터가 1에 수렴하는 것을 확인할 수 있습니다. - 표준편차는 1로 두고 평균만 5, 6, 7, …로 하나씩 키워 가며
epoch f의 절댓값이 처음으로 1을 넘는 평균을 찾아보세요. 이 데이터와 학습률 0.008에서는 평균 11까지는 수렴하고, 12부터 발산합니다.