딥러닝 역전파를 덧셈·뺄셈·곱셈·제곱·평균 노드 5개로 나눠 이해합니다. 순전파와 역전파를 손으로 따라가고, C++·파이썬 노드 코드로 2편 공식과 같은 결과가 나오는지 확인합니다.
2편에서는 loss (y − θx)²를 손으로 미분해 기울기 −2x(y − ŷ)를 구했습니다. 식이 짧아서 가능한 일이었습니다. 하지만 층이 수십 개인 신경망에서는 loss 식을 한 줄로 쓰는 것조차 어렵습니다. 그런데도 딥러닝 프레임워크는 어떤 모델이든 기울기를 자동으로 계산합니다. 그 방법이 이번 글의 주제인 딥러닝 역전파입니다.
연재 안내: 전체 12편의 순서와 공개된 글은 딥러닝 수학 C++ 구현 로드맵에서 확인할 수 있습니다.
한 줄 답변
역전파는 복잡한 식을 한 가지 연산만 하는 작은 노드로 쪼갠 뒤, 출력에서 입력 방향으로 거꾸로 가면서 “뒤에서 넘어온 기울기 × 자기 노드의 국소 미분”을 차례로 전달해 기울기를 구하는 방법입니다. 각 노드는 자기 연산의 미분만 알면 되므로, 전체 식이 아무리 길어도 같은 규칙으로 기울기를 계산할 수 있습니다.
이 글에서 바로 답하는 것
- 계산 그래프가 무엇이고, 왜 식을 노드로 쪼개는지
- 순전파와 역전파가 각각 무엇을 계산하는지
- 덧셈·뺄셈·곱셈·제곱·평균 노드가 기울기를 어떻게 전달하는지
- 노드로 구한 기울기가 손으로 유도한 공식과 정말 같은지
이 글에 나오는 용어
| 용어 | 뜻 |
|---|---|
| 계산 그래프 (computational graph) | 식을 연산 단위의 노드와 값이 흐르는 화살표로 그린 그림 |
| 노드 (node) | 덧셈, 곱셈처럼 한 가지 연산만 하는 계산 단위 |
| 순전파 (forward propagation) | 입력에서 출력 방향으로 값을 계산하는 과정. 예측과 loss를 구함 |
| 역전파 (backpropagation) | 출력에서 입력 방향으로 기울기를 전달하는 과정. 각 파라미터의 기울기를 구함 |
| 국소 미분 (local gradient) | 노드 하나가 “자기 출력을 자기 입력으로 미분한 값”. 노드 안에서만 계산됨 |
| 상류 기울기 (upstream gradient) | 뒤쪽(출력 쪽) 노드에서 넘어온 기울기. 코드에서는 보통 dz로 씀 |
식을 노드로 쪼개기
loss L = (y − θx)²는 연산 세 개로 이루어져 있습니다. 하나씩 이름을 붙여 쪼개면 다음과 같습니다.
z1 = θ × x        ← 곱셈 노드 (예측값)
z2 = y − z1       ← 뺄셈 노드 (오차)
L  = z2²          ← 제곱 노드 (loss)
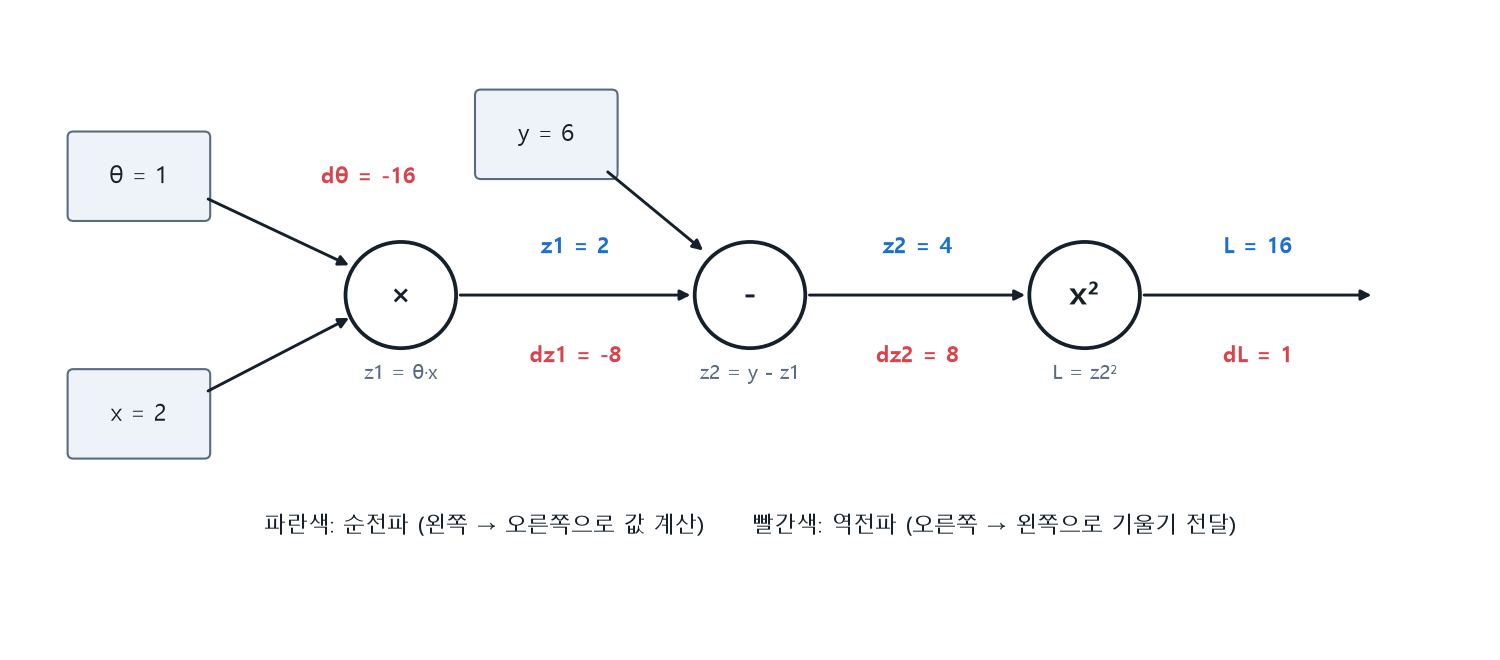
각 줄은 단순한 연산 하나뿐입니다. 이것을 화살표로 이으면 계산 그래프가 됩니다. 숫자 θ = 1, x = 2, y = 6을 넣어서 한 번 따라가 보겠습니다. 2편에서 기울기가 −16이었던 그 샘플입니다.
순전파: 왼쪽에서 오른쪽으로 값 계산
z1 = θ × x  = 1 × 2 = 2
z2 = y − z1 = 6 − 2 = 4
L  = z2²    = 4²    = 16
예측을 하고 loss를 재는, 1편부터 해 온 계산과 같습니다. 다른 점은 각 노드가 자기 입력을 기억해 둔다는 것입니다. 역전파에서 그 값이 필요합니다.
역전파: 오른쪽에서 왼쪽으로 기울기 전달
역전파는 맨 끝에서 dL/dL = 1로 시작합니다. “L을 조금 바꾸면 L이 그만큼 바뀐다”는 당연한 사실입니다. 그다음 각 노드가 넘어온 기울기에 자기 국소 미분을 곱해서 앞쪽으로 넘깁니다.
제곱 노드:  국소 미분 2·z2 = 8      →  dz2 = 1 × 8    = 8
뺄셈 노드:  z1 쪽 국소 미분 −1      →  dz1 = 8 × (−1) = −8
곱셈 노드:  θ 쪽 국소 미분 x = 2    →  dθ  = −8 × 2   = −16
결과 dθ = −16은 2편에서 공식 −2x(y − ŷ) = −2 × 2 × (6 − 2)로 구한 값과 같습니다. 이것이 연쇄법칙입니다. 2편의 방법 B에서 바깥 미분과 안쪽 미분을 곱했던 것을 노드 단위로 나눠서 한 것뿐입니다.
노드 5개의 국소 미분
이 연재의 선형회귀 계산은 모두 아래 다섯 노드의 조합으로 표현할 수 있습니다. 실제 신경망에는 활성화 함수 같은 노드가 더 필요하지만, 각 노드가 자기 연산의 미분만 알면 된다는 원리는 같습니다.
| 노드 | 순전파 | 역전파 (dz를 받아서 돌려주는 값) | 기억할 점 |
|---|---|---|---|
| 덧셈 | z = x + y | x 쪽 dz, y 쪽 dz | 기울기를 그대로 복사 |
| 뺄셈 | z = x − y | x 쪽 dz, y 쪽 −dz | 빼지는 쪽만 부호 반전 |
| 곱셈 | z = x × y | x 쪽 dz × y, y 쪽 dz × x | 상대 입력을 곱함 |
| 제곱 | z = x² | dz × 2x | 입력값 x가 필요 |
| 평균 | z = (x₁ + … + xₙ) / n | 모든 xᵢ에 dz / n | 기울기를 n등분해 똑같이 나눔 |
곱셈과 제곱 노드의 역전파에는 순전파 때의 입력값이 들어갑니다. 그래서 노드가 순전파에서 입력을 저장해 두는 것입니다. 실제 딥러닝 프레임워크가 학습 중에 메모리를 많이 쓰는 이유 중 하나도 이 저장 때문입니다.
C++로 구현한 노드에 숫자를 넣어 확인한 결과입니다. 덧셈·뺄셈·곱셈은 x = 2, y = 3, 제곱은 x = 3, 평균은 [1, 2, 3, 4, 5]를 넣었고, 뒤에서 넘어온 기울기는 모두 dz = 2입니다.
| 노드 | 순전파 결과 z | 역전파 결과 |
|---|---|---|
| 덧셈 | 5 | (2, 2) |
| 뺄셈 | −1 | (2, −2) |
| 곱셈 | 6 | (6, 4) |
| 제곱 | 9 | 12 |
| 평균 | 3 | [0.4, 0.4, 0.4, 0.4, 0.4] |
이번 글의 모델에는 곱셈·뺄셈·제곱 노드만 쓰입니다. 평균 노드는 여러 샘플의 loss를 한 번에 다루는 6편에서, 덧셈 노드는 bias를 더하는 7편에서 다시 등장합니다.
C++와 파이썬 코드로 확인하기
노드를 클래스로 만들고, 두 가지를 확인합니다.
θ = 1, x = 2, y = 6으로 순전파와 역전파를 한 번씩 해서 위의 손계산과 같은지- 3편의 샘플 세 개(x = 0.5, 1, 1.7)를 노드로 학습한 결과가 2편 갱신식으로 학습한 결과와 같은지
C++ (C++17, 외부 라이브러리 없음)
#include <cmath>
#include <cstdio>
#include <utility>
#include <vector>

class MulNode {                                   // z = x * y
public:
    double Forward(double x, double y) {
        x_ = x; y_ = y;                           // 역전파에 쓰려고 입력을 저장
        return x * y;
    }
    std::pair<double, double> Backward(double dz) const {
        return {dz * y_, dz * x_};                // 서로 상대 입력을 곱해서 돌려줌
    }
private:
    double x_ = 0, y_ = 0;
};

class MinusNode {                                 // z = x - y
public:
    double Forward(double x, double y) { return x - y; }
    std::pair<double, double> Backward(double dz) const {
        return {dz, -dz};                         // 빼지는 쪽은 부호를 뒤집음
    }
};

class SquareNode {                                // z = x²
public:
    double Forward(double x) {
        x_ = x;
        return x * x;
    }
    double Backward(double dz) const { return dz * 2.0 * x_; }   // 제곱의 미분 2x
private:
    double x_ = 0;
};

int main() {
    MulNode mul;
    MinusNode minus;
    SquareNode square;

    // 1) 샘플 하나 (x=2, y=6, θ=1)로 순전파와 역전파를 한 번씩
    {
        const double th = 1.0, x = 2.0, y = 6.0;
        const double z1 = mul.Forward(th, x);     // 순전파: 입력 → 출력
        const double z2 = minus.Forward(y, z1);
        const double l = square.Forward(z2);
        const double dz2 = square.Backward(1.0);  // 역전파: 출력 → 입력 (dL/dL = 1에서 시작)
        const auto [dy, dz1] = minus.Backward(dz2);
        const auto [dth, dx] = mul.Backward(dz1);
        std::printf("forward : z1=%g, z2=%g, L=%gn", z1, z2, l);
        std::printf("backward: dz2=%g, dz1=%g, dth=%g  (formula -2x(y-pred) = %g)n",
                    dz2, dz1, dth, -2.0 * x * (y - th * x));
    }

    // 2) 노드로 학습한 결과와 2편 갱신식으로 학습한 결과 비교
    const std::vector<std::pair<double, double>> samples = {{0.5, 1.5}, {1.0, 3.0}, {1.7, 5.1}};
    double th_node = 0.1, th_formula = 0.1;
    const double lr = 0.1;
    for (int epoch = 0; epoch < 10; ++epoch) {
        for (const auto& [x, y] : samples) {
            const double z1 = mul.Forward(th_node, x);
            const double z2 = minus.Forward(y, z1);
            square.Forward(z2);
            const double dz2 = square.Backward(1.0);
            const double dz1 = minus.Backward(dz2).second;
            const double dth = mul.Backward(dz1).first;
            th_node = th_node - lr * dth;                                  // 노드로 구한 기울기
            th_formula = th_formula + 2.0 * x * lr * (y - th_formula * x); // 2편 갱신식
        }
    }
    std::printf("nodes  : th = %.5fn", th_node);
    std::printf("formula: th = %.5fn", th_formula);
    std::printf("diff   : %.1en", std::fabs(th_node - th_formula));
}
Python (표준 라이브러리만 사용)
class MulNode:                              # z = x * y
    def forward(self, x, y):
        self.x, self.y = x, y               # 역전파에 쓰려고 입력을 저장
        return x * y
    def backward(self, dz):
        return dz * self.y, dz * self.x     # 서로 상대 입력을 곱해서 돌려줌

class MinusNode:                            # z = x - y
    def forward(self, x, y):
        return x - y
    def backward(self, dz):
        return dz, -dz                      # 빼지는 쪽은 부호를 뒤집음

class SquareNode:                           # z = x²
    def forward(self, x):
        self.x = x
        return x * x
    def backward(self, dz):
        return dz * 2 * self.x              # 제곱의 미분 2x

mul, minus, square = MulNode(), MinusNode(), SquareNode()

# 1) 샘플 하나 (x=2, y=6, θ=1)로 순전파와 역전파를 한 번씩
th, x, y = 1.0, 2.0, 6.0
z1 = mul.forward(th, x)                     # 순전파: 입력 → 출력
z2 = minus.forward(y, z1)
l = square.forward(z2)
dz2 = square.backward(1.0)                  # 역전파: 출력 → 입력 (dL/dL = 1에서 시작)
dy, dz1 = minus.backward(dz2)
dth, dx = mul.backward(dz1)
print(f"forward : z1={z1:g}, z2={z2:g}, L={l:g}")
print(f"backward: dz2={dz2:g}, dz1={dz1:g}, dth={dth:g}  (formula -2x(y-pred) = {-2 * x * (y - th * x):g})")

# 2) 노드로 학습한 결과와 2편 갱신식으로 학습한 결과 비교
samples = [(0.5, 1.5), (1.0, 3.0), (1.7, 5.1)]
th_node, th_formula, lr = 0.1, 0.1, 0.1
for epoch in range(10):
    for x, y in samples:
        z1 = mul.forward(th_node, x)
        z2 = minus.forward(y, z1)
        l = square.forward(z2)
        dz2 = square.backward(1.0)
        dy, dz1 = minus.backward(dz2)
        dth, dx = mul.backward(dz1)
        th_node = th_node - lr * dth                              # 노드로 구한 기울기
        th_formula = th_formula + 2 * x * lr * (y - th_formula * x)  # 2편 갱신식
print(f"nodes  : th = {th_node:.5f}")
print(f"formula: th = {th_formula:.5f}")
print(f"diff   : {abs(th_node - th_formula):.1e}")
실행 결과
forward : z1=2, z2=4, L=16
backward: dz2=8, dz1=-8, dth=-16  (formula -2x(y-pred) = -16)
nodes  : th = 2.99997
formula: th = 2.99997
diff   : 0.0e+00
첫 두 줄은 그림과 손계산 그대로입니다. 아래 세 줄은 노드로 기울기를 구해 학습한 θ와 2편 공식으로 학습한 θ가 끝까지 똑같다는 뜻입니다. 3편의 같은 실험(학습률 0.1, 10 epoch) 결과 2.99997과도 일치합니다.
C++ 코드에서 const auto [dy, dz1] = ...처럼 쓴 문법은 C++17의 구조적 바인딩으로, 파이썬의 dy, dz1 = ...와 같은 역할을 합니다. 노드가 두 입력의 기울기를 한 쌍으로 돌려주는데, 이 모델에서는 dy와 dx는 쓰지 않습니다. 정답 y와 입력 x는 학습으로 바꾸는 값이 아니기 때문입니다.
왜 굳이 노드로 쪼갤까
이번 예제에서는 공식 한 줄이 노드 코드보다 훨씬 짧습니다. 그런데도 노드 방식을 쓰는 이유는 세 가지입니다.
- 모델이 바뀌어도 노드는 그대로입니다. 7편에서 bias를 추가하면 덧셈 노드 하나만 끼워 넣으면 됩니다. 공식 방식이라면 미분을 처음부터 다시 해야 합니다.
- 노드마다 따로 검증할 수 있습니다. 위의 노드 5개 표처럼 노드 하나씩 숫자를 넣어 확인해 두면, 그 조합인 큰 모델도 믿을 수 있습니다.
- 딥러닝 프레임워크가 실제로 이렇게 동작합니다. PyTorch나 TensorFlow는 사용자가 쓴 식을 내부에서 노드의 그래프로 기록해 두었다가, 기울기를 요청하면(PyTorch의
loss.backward(), TensorFlow의GradientTape) 이 글과 같은 순서로 기울기를 전달합니다.
흔히 헷갈리는 부분
역전파는 학습 방법이 아니라 기울기 계산 방법입니다
역전파는 dθ를 구하는 데까지만 합니다. θ를 실제로 바꾸는 것은 그다음 줄의 경사하강법 θ ← θ − α · dθ입니다. “역전파로 학습한다”는 말은 “역전파로 기울기를 구하고 경사하강법으로 갱신한다”를 줄인 표현입니다.
곱셈 노드는 자기 입력이 아니라 상대 입력을 곱합니다
z = θ × x를 θ로 미분하면 x가 남습니다. 그래서 θ 쪽으로는 dz × x가 갑니다. 처음 구현할 때 dz × θ로 잘못 쓰는 경우가 많은데, 이러면 기울기가 완전히 틀어집니다.
순전파를 먼저 하지 않으면 역전파를 할 수 없습니다
곱셈과 제곱 노드의 역전파에는 순전파 때 저장한 입력이 필요합니다. 그래서 학습 한 번은 항상 “순전파 → 역전파 → 갱신” 순서입니다.
딥러닝 역전파 정리
- 계산 그래프는 식을 한 가지 연산만 하는 노드로 쪼갠 그림입니다.
- 순전파는 입력에서 출력으로 값을 계산하고, 역전파는 출력에서 입력으로 “넘어온 기울기 × 국소 미분”을 전달합니다.
- 덧셈은 복사, 뺄셈은 한쪽 부호 반전, 곱셈은 상대 입력 곱하기, 제곱은 2x 곱하기, 평균은 n등분입니다.
- 노드로 구한 기울기와 손으로 유도한 공식은 정확히 같은 학습 결과를 냅니다.
다음 글에서는 입력 x가 어떤 분포에서 뽑히느냐에 따라 같은 학습률이 왜 잘 되기도 하고 실패하기도 하는지, 데이터 쪽에서 학습을 살펴봅니다.
직접 해 보는 작은 실습
MulNode의 역전파를 일부러{dz * x_, dz * y_}로 바꿔(상대 입력이 아니라 자기 입력을 곱하도록) 실행해 보세요.dth가 −16이 아니라 −8로 틀리게 나옵니다. 그런데 학습 결과는 오히려 3.00000으로 정답에 도착합니다. 이 데이터는 x와 θ가 모두 양수라 틀린 기울기도 방향(부호)만은 맞았기 때문입니다. 기울기가 틀려도 학습이 “잘 되는 것처럼” 보일 수 있다는 점이 중요합니다. 그래서 학습 결과만 보지 말고, 노드 5개 표처럼 노드 하나씩 숫자로 검증해야 합니다.- 덧셈 노드
PlusNode를 직접 만들어 보세요. 순전파는x + y, 역전파는{dz, dz}입니다. 7편에서 bias를 더할 때 이 노드를 그대로 씁니다.