딥러닝 학습률을 키우면 왜 진동하고 발산하는지, 남은 거리에 곱해지는 배수 (1 − 2x²α) 하나로 설명하고 C++·파이썬 실행 결과로 확인합니다.
딥러닝 모델을 처음 학습시키면 가장 먼저 부딪히는 문제가 학습률입니다. 너무 작으면 몇 시간을 돌려도 제자리이고, 조금 키우면 loss가 갑자기 터져 버립니다. 이번 글에서는 딥러닝 학습률이 정확히 어느 선에서 “느림”, “진동”, “발산”으로 갈리는지, 숫자 하나로 판단하는 방법을 직접 유도하고 실행 결과로 확인합니다.
연재 안내: 전체 12편의 순서와 공개된 글은 딥러닝 수학 C++ 구현 로드맵에서 확인할 수 있습니다. 이 글은 2편: 경사하강법 갱신식 유도에서 이어집니다.
한 줄 답변
샘플 하나로 학습할 때, 한 번 갱신하면 정답까지 남은 거리가 f = 1 − 2x²α배가 됩니다. 0 < f < 1이면 부드럽게 수렴하고, −1 < f < 0이면 정답을 넘나들며 진동하다 수렴하고, |f| > 1이면 갱신할수록 멀어져 발산합니다. 그래서 안전한 학습률의 상한은 1/x²이고, 입력 x가 클수록 학습률을 작게 잡아야 합니다.
이 글에서 바로 답하는 것
- 학습률이 크면 왜 바닥을 지나치고, 어디서부터 발산하는지
- 수렴·진동·발산을 가르는 경계값을 계산하는 방법
- 같은 학습률이 x에 따라 안전하기도 하고 위험하기도 한 이유
- 샘플이 여러 개일 때 학습률을 판단하는 방법
이 글에 나오는 용어
| 용어 | 뜻 |
|---|---|
| 수렴 (convergence) | 갱신을 반복할수록 파라미터가 한 값(여기서는 정답 3)에 점점 가까워지는 것 |
| 진동 (oscillation) | 파라미터가 정답을 넘었다 돌아오기를 반복하는 것. 폭이 줄면 결국 수렴함 |
| 발산 (divergence) | 갱신할수록 정답에서 점점 멀어져 숫자가 폭발하는 것 |
배수 f | 한 번 갱신할 때 “정답까지 남은 거리”에 곱해지는 수. 이 글에서는 1 − 2x²α |
| 하이퍼파라미터 (hyperparameter) | 학습으로 바뀌지 않고 사람이 미리 정하는 값. 학습률, epoch 수, 배치 크기 등 |
남은 거리에 곱해지는 수 하나
2편에서 유도한 갱신식에서 출발합니다. 데이터가 y = 3x라면 y − θx = x(3 − θ)이므로 다음과 같이 정리됩니다.
θ_new = θ + 2αx(y − θx)
      = θ + 2αx²(3 − θ)
양변에서 정답 3을 빼면 식이 깔끔해집니다.
θ_new − 3 = (1 − 2x²α)(θ − 3)갱신 후 남은 거리 = 배수 f × 갱신 전 남은 거리라는 뜻입니다. f는 θ와 상관없이 x와 α만으로 정해지므로, 같은 샘플로 k번 갱신하면 남은 거리는 정확히 f의 k제곱배가 됩니다. 학습이 어떻게 흘러갈지를 갱신해 보기 전에 숫자 하나로 미리 알 수 있습니다.
배수 f로 갈리는 다섯 가지 경우
| 배수 f | 학습률 범위 (x = 1일 때) | 결과 |
|---|---|---|
0 < f < 1 | α < 1/(2x²) (0.5 미만) | 한쪽에서만 다가가며 부드럽게 수렴 |
f = 0 | α = 1/(2x²) (정확히 0.5) | 한 번에 정답 도착 |
−1 < f < 0 | 1/(2x²) < α < 1/x² (0.5~1) | 정답을 넘나들며 진동하다 수렴 |
f = −1 | α = 1/x² (정확히 1) | 같은 두 값을 영원히 왕복 |
f < −1 | α > 1/x² (1 초과) | 넘을 때마다 더 멀리 → 발산 |
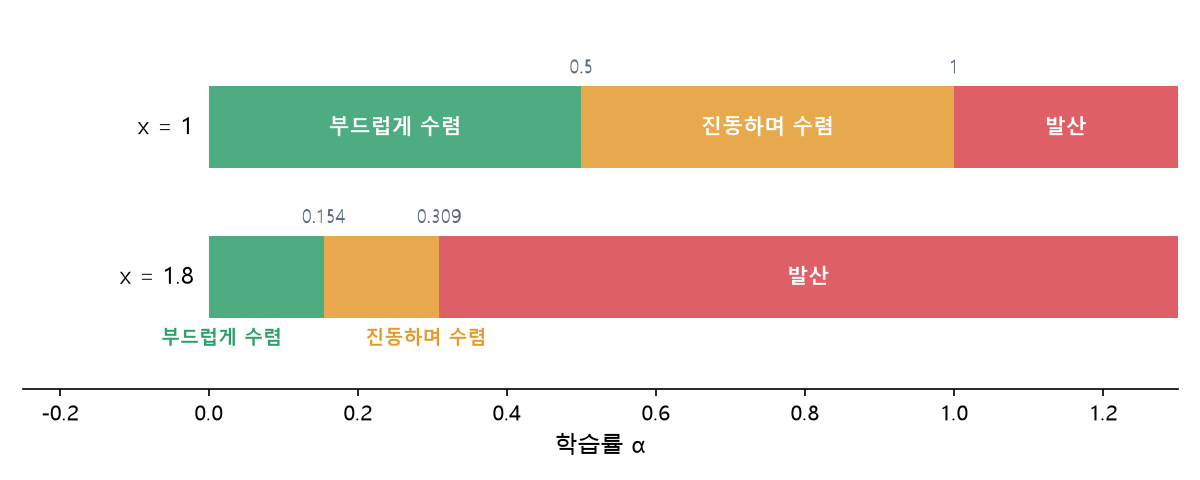
경계값 1/(2x²)와 1/x²에 x²이 들어 있다는 점이 중요합니다. x = 1일 때는 학습률 0.9도 수렴하지만, x = 1.8이 되면 경계가 0.154와 0.309로 줄어들어 0.3만 써도 발산 직전입니다.
손으로 따라가는 진동
x = 1, 학습률 0.8이면 f = 1 − 2 × 1 × 0.8 = −0.6입니다. 시작값 0.1에서 세 번 갱신해 보겠습니다.
| 갱신 | θ | 정답까지 거리 (θ − 3) | 앞 거리의 몇 배 |
|---|---|---|---|
| 0 | 0.1 | −2.9 | |
| 1 | 4.74 | +1.74 | −0.6 |
| 2 | 1.956 | −1.044 | −0.6 |
| 3 | 3.6264 | +0.6264 | −0.6 |
거리의 부호가 매번 바뀝니다. θ가 3을 넘어 4.74로 갔다가, 다시 3 아래 1.956으로 돌아오는 식입니다. 그래도 크기는 매번 0.6배로 줄어들므로 결국 3에 수렴합니다.
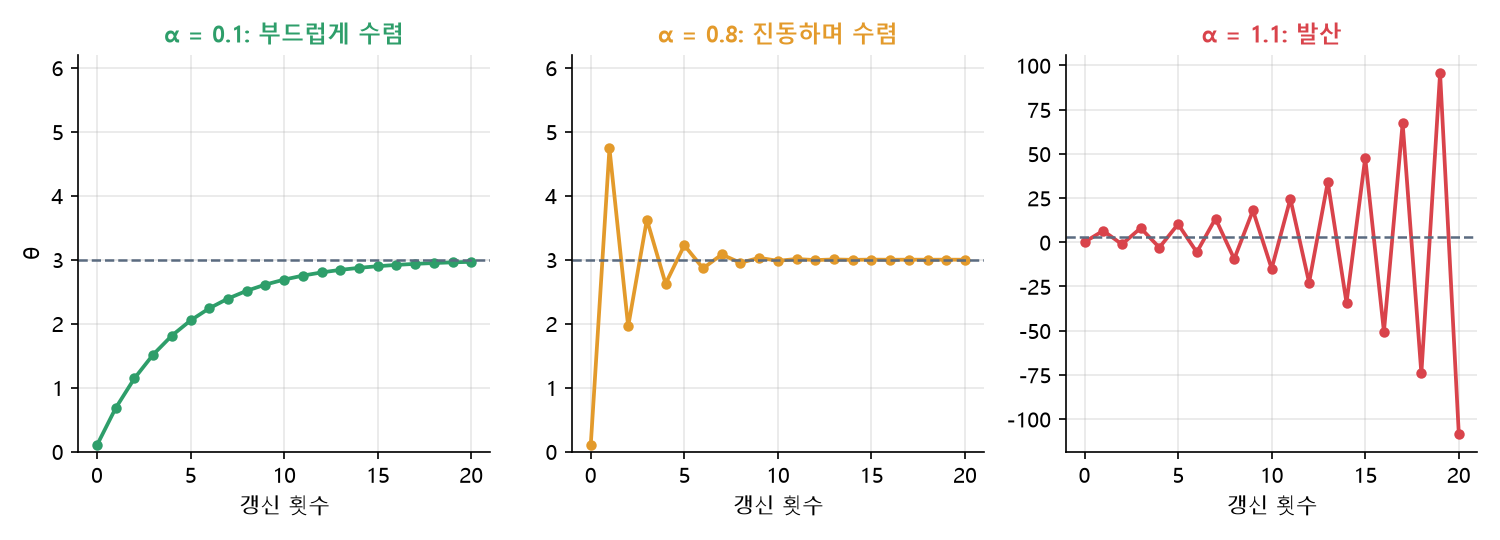
학습률이 1.1이 되면 f = −1.2입니다. 같은 진동이지만 넘을 때마다 1.2배씩 멀어져서, 20번 만에 θ가 −108까지 튀어 나갑니다.
C++와 파이썬 코드로 확인하기
세 가지 실험을 한 번에 돌려 보겠습니다.
- x = 1로 고정하고 학습률만 바꾸기
- 학습률 0.3으로 고정하고 x만 바꾸기
- 샘플 세 개(x = 0.5, 1, 1.7)를 순서대로 10 epoch 학습하기
C++ (C++17, 외부 라이브러리 없음)
#include <cstdio>
#include <initializer_list>
#include <utility>
#include <vector>

double TrainSingleSample(int iterations, double lr, double x, double y, double th = 0.1) {
    for (int it = 0; it < iterations; ++it)
        th = th + 2.0 * x * lr * (y - th * x);           // 2편에서 유도한 갱신식
    return th;
}

double TrainEpochs(const std::vector<std::pair<double, double>>& samples, double lr, int epochs,
                   double th = 0.1) {
    for (int epoch = 0; epoch < epochs; ++epoch)
        for (const auto& [x, y] : samples)               // 샘플 순서대로 하나씩 갱신
            th = th + 2.0 * x * lr * (y - th * x);
    return th;
}

int main() {
    // 실험 1: 샘플 하나 (x=1, y=3), 학습률만 바꿔서 20번 갱신
    const double x1 = 1.0;
    for (double lr : {0.1, 0.5, 0.8, 1.0, 1.1}) {
        const double factor = 1.0 - 2.0 * x1 * x1 * lr;  // 남은 거리에 곱해지는 배수
        std::printf("lr=%-4g factor=%+.2f  th after 20 = %.5fn", lr, factor,
                    TrainSingleSample(20, lr, x1, 3 * x1));
    }

    // 실험 2: 같은 학습률 0.3, x만 바꾸기
    for (double x : {0.5, 1.0, 1.8}) {
        const double factor = 1.0 - 2.0 * x * x * 0.3;
        std::printf("x=%-4g factor=%+.3f  th after 20 = %.5fn", x, factor,
                    TrainSingleSample(20, 0.3, x, 3 * x));
    }

    // 실험 3: 샘플 세 개 (x=0.5, 1, 1.7)를 순서대로 10 epoch
    const std::vector<std::pair<double, double>> samples = {{0.5, 1.5}, {1.0, 3.0}, {1.7, 5.1}};
    for (double lr : {0.01, 0.1, 0.6, 1.0})
        std::printf("3 samples, lr=%-4g  th after 10 epochs = %.5fn", lr, TrainEpochs(samples, lr, 10));
}
Python (표준 라이브러리만 사용)
def train_single_sample(iterations, lr, x, y, th=0.1):
    for _ in range(iterations):
        th = th + 2 * x * lr * (y - th * x)       # 2편에서 유도한 갱신식
    return th

def train_epochs(samples, lr, epochs, th=0.1):
    for _ in range(epochs):
        for x, y in samples:                       # 샘플 순서대로 하나씩 갱신
            th = th + 2 * x * lr * (y - th * x)
    return th

# 실험 1: 샘플 하나 (x=1, y=3), 학습률만 바꿔서 20번 갱신
x1 = 1.0
for lr in [0.1, 0.5, 0.8, 1.0, 1.1]:
    factor = 1 - 2 * x1 * x1 * lr                  # 남은 거리에 곱해지는 배수
    print(f"lr={lr:<4g} factor={factor:+.2f}  th after 20 = {train_single_sample(20, lr, x1, 3 * x1):.5f}")

# 실험 2: 같은 학습률 0.3, x만 바꾸기
for x in [0.5, 1.0, 1.8]:
    factor = 1 - 2 * x * x * 0.3
    print(f"x={x:<4g} factor={factor:+.3f}  th after 20 = {train_single_sample(20, 0.3, x, 3 * x):.5f}")

# 실험 3: 샘플 세 개 (x=0.5, 1, 1.7)를 순서대로 10 epoch
samples = [(0.5, 1.5), (1.0, 3.0), (1.7, 5.1)]
for lr in [0.01, 0.1, 0.6, 1.0]:
    print(f"3 samples, lr={lr:<4g}  th after 10 epochs = {train_epochs(samples, lr, 10):.5f}")
실행 결과
lr=0.1  factor=+0.80  th after 20 = 2.96657
lr=0.5  factor=+0.00  th after 20 = 3.00000
lr=0.8  factor=-0.60  th after 20 = 2.99989
lr=1    factor=-1.00  th after 20 = 0.10000
lr=1.1  factor=-1.20  th after 20 = -108.17904
x=0.5  factor=+0.850  th after 20 = 2.88760
x=1    factor=+0.400  th after 20 = 3.00000
x=1.8  factor=-0.944  th after 20 = 2.08412
3 samples, lr=0.01  th after 10 epochs = 1.75743
3 samples, lr=0.1   th after 10 epochs = 2.99997
3 samples, lr=0.6   th after 10 epochs = 2.99993
3 samples, lr=1     th after 10 epochs = -17632.06267
결과 읽기
실험 1: 학습률만 바꿨을 때
- 0.1은 안전하지만 20번 갱신해도 2.96657로, 아직 정답에 닿지 않았습니다.
- 0.5는
f = 0이라 첫 갱신 한 번 만에 정확히 3에 도착합니다. - 0.8은 진동하면서도 2.99989까지 왔습니다. 진동한다고 해서 무조건 나쁜 학습률은 아닙니다.
- 1.0은
f = −1이라 0.1과 5.9 사이를 영원히 왕복합니다. 20번(짝수 번) 갱신 후에는 처음 값 0.1로 돌아와 있습니다. - 1.1은 −108로 튀었습니다. 갱신을 더 하면 숫자가 계속 커져 결국 컴퓨터가 표현할 수 있는 범위를 넘습니다.
실험 2: x만 바꿨을 때
같은 학습률 0.3인데 결과가 전혀 다릅니다. x = 1은 f = 0.4로 20번 안에 3에 도착했고, x = 0.5는 f = 0.85로 느리게 2.88760까지 왔습니다. x = 1.8은 f = −0.944라서 겨우 수렴하는 범위 안이지만, 매번 거리가 5.6%씩밖에 줄지 않아 20번 후에도 2.08412에서 크게 출렁이고 있습니다.
학습률은 그 자체로 크다, 작다를 말할 수 없습니다. 데이터의 x 크기와 함께 봐야 합니다.
실험 3: 샘플이 여러 개일 때
샘플이 여러 개면 샘플마다 배수가 다릅니다. 한 epoch 동안 세 샘플을 차례로 쓰면 남은 거리에는 세 배수의 곱이 곱해집니다.
| 학습률 | x = 0.5의 f | x = 1의 f | x = 1.7의 f | 1 epoch 배수(곱) | 10 epoch 후 θ |
|---|---|---|---|---|---|
| 0.01 | +0.995 | +0.980 | +0.942 | +0.919 | 1.75743 |
| 0.1 | +0.950 | +0.800 | +0.422 | +0.321 | 2.99997 |
| 0.6 | +0.700 | −0.200 | −2.468 | +0.346 | 2.99993 |
| 1.0 | +0.500 | −1.000 | −4.780 | +2.390 | −17632 |
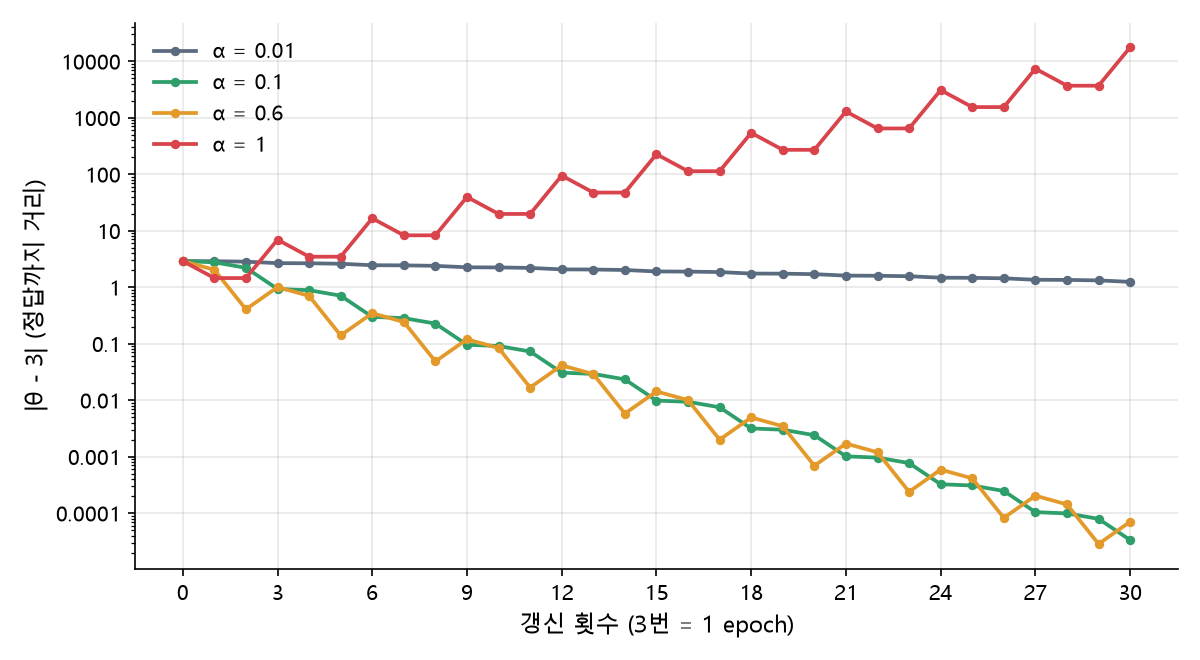
학습률 0.6은 흥미로운 경우입니다. x = 1.7 샘플만 놓고 보면 f = −2.468이라 발산해야 하지만, 다른 두 샘플이 거리를 충분히 줄여 주어 epoch 전체로는 0.346배씩 줄어들었습니다. 다만 이것은 세 샘플의 정답이 모두 정확히 3인 이 실험이라서 가능한 일입니다. 잡음이 있는 실제 데이터에서는 x가 큰 샘플 하나가 θ를 크게 튕겨 내 학습을 흔들 수 있으므로, 가장 큰 x 기준의 상한 1/x_max²(여기서는 1/1.7² ≈ 0.35)을 안전선으로 보는 편이 좋습니다. 위 표의 1 epoch 배수 0.346과 숫자가 비슷한 것은 우연이고, 서로 다른 값입니다.
실전에서 학습률을 고르는 순서
수식으로 정확한 상한을 계산할 수 있는 경우는 거의 없지만, 이 글의 원리는 그대로 통합니다.
- 입력의 크기부터 봅니다. 입력값이 수십, 수백 단위라면 아주 작은 학습률이 필요합니다.
- 작은 값에서 10배씩 키워 봅니다. 0.0001 → 0.001 → 0.01 → 0.1 순서로 짧게 학습해 비교합니다.
- 학습 곡선을 봅니다. loss가 위아래로 크게 출렁이면 학습률을 줄이고, 숫자가 폭발하면 크게 줄입니다. 너무 천천히 내려가면 키웁니다.
- 입력 크기를 맞추는 것도 방법입니다. 학습률을 줄이는 대신 입력을 비슷한 크기로 바꾸면 같은 학습률로도 안정적으로 학습됩니다. 이것이 10편에서 다룰 Feature Scaling입니다.
흔히 헷갈리는 부분
진동하는 학습률이 늘 나쁜 것은 아닙니다
실험 1에서 0.8은 진동했지만 0.1보다 정답에 더 가까이 갔습니다. |f|가 작을수록 빠르므로, 0.8(|f| = 0.6)이 0.1(|f| = 0.8)보다 빠릅니다. 문제는 진동 자체가 아니라 |f|가 1에 가까워지거나 넘는 것입니다.
loss가 줄지 않는 이유가 학습률이 작아서만은 아닙니다
학습률 1.0처럼 f = −1이면 θ가 두 값을 왕복하면서 loss도 같은 값을 반복합니다. 그래프만 보면 “학습이 멈췄다”처럼 보이지만 실제로는 학습률이 너무 큰 경우입니다. θ가 정답을 사이에 두고 두 값을 번갈아 오가는지 함께 확인하세요.
같은 학습률을 다른 데이터에 그대로 쓰면 위험합니다
다른 글이나 예제에서 잘 됐던 학습률도 입력 크기가 다르면 발산할 수 있습니다. 실험 2에서 0.3은 x = 1에서는 20번 안에 정답에 도착했지만, x = 1.8에서는 발산 직전이었습니다.
딥러닝 학습률 정리
- 샘플 하나로 학습할 때 남은 거리는 매번
f = 1 − 2x²α배가 됩니다. |f| < 1이면 수렴하고(음수면 진동하며),|f| > 1이면 발산합니다. 안전한 상한은α < 1/x²입니다.- 상한이 x²에 반비례하므로, 입력이 클수록 학습률을 작게 잡아야 합니다.
- 샘플이 여러 개면 한 epoch의 배수는 샘플별 배수의 곱이지만, 실전에서는 가장 큰 x 기준의 상한을 안전선으로 봅니다.
다음 글에서는 지금까지 손으로 유도했던 미분을, 식이 복잡해져도 자동으로 계산할 수 있게 해 주는 계산 그래프와 역전파를 노드 5개로 살펴봅니다.
직접 해 보는 작은 실습
- 실험 1에 학습률 0.99를 넣어 보세요.
f = −0.98이라 수렴은 하지만, 20번 후에도 θ가 약 1.06으로 처음 거리의 3분의 2 정도가 그대로 남아 있는 것을 확인할 수 있습니다. 같은|f| = 0.98인 학습률 0.01과 속도가 같다는 점도 비교해 보세요. - 실험 3의 샘플 순서를
{1.7, 5.1}이 맨 앞에 오도록 바꿔 보세요. 10 epoch 후의 θ가 같은지 다른지 확인하고, 그 이유를 배수의 곱으로 설명해 보세요.